कृत्रिम बुद्धिमत्ता संगणकीय प्रणालींसह मानवी सारख्या परस्परसंवादाला चालना देते, तर मशीन लर्निंग या मशीन्सना प्रत्येक परस्परसंवादाद्वारे मानवी बुद्धिमत्तेची नक्कल करण्यास शिकण्यास अनुमती देते. परंतु या अत्यंत प्रगत ML आणि AI साधनांना कोणती शक्ती देते? डेटा भाष्य.
डेटा हा ML अल्गोरिदमला शक्ती देणारा कच्चा माल आहे – तुम्ही जितका जास्त डेटा वापराल, तितके AI उत्पादन चांगले होईल. मोठ्या प्रमाणात डेटामध्ये प्रवेश असणे अत्यंत महत्त्वाचे असले तरी, व्यवहार्य परिणाम देण्यासाठी ते अचूकपणे भाष्य केले असल्याची खात्री करणे देखील तितकेच महत्त्वाचे आहे. डेटा भाष्य हे प्रगत, विश्वासार्ह आणि अचूक ML अल्गोरिदमिक कार्यक्षमतेमागील डेटा पॉवरहाऊस आहे.
एआय प्रशिक्षणात डेटा भाष्याची भूमिका
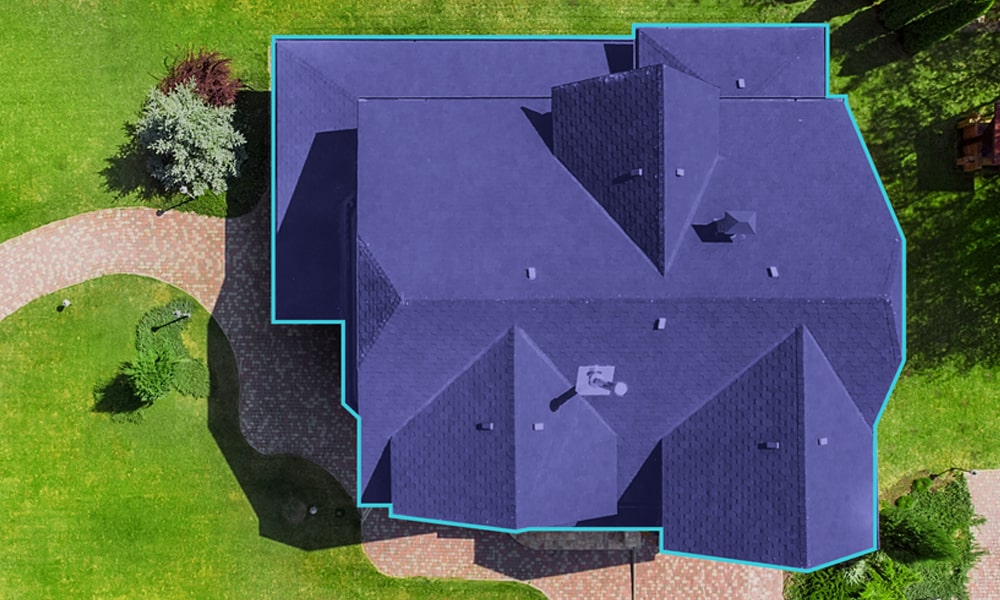
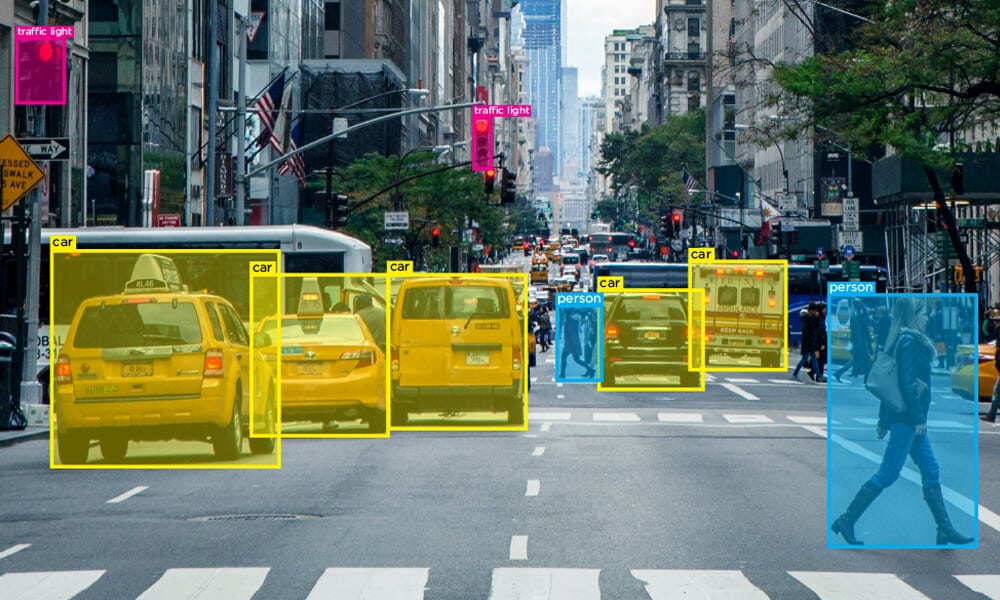
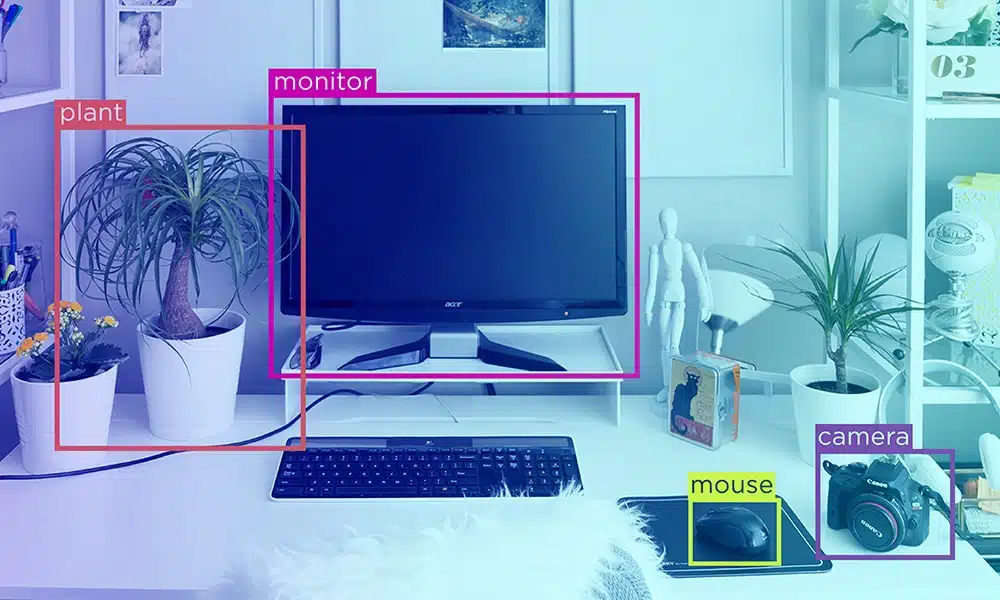
ML प्रशिक्षण आणि AI प्रकल्पांच्या एकूण यशामध्ये डेटा भाष्य महत्त्वाची भूमिका बजावते. हे विशिष्ट प्रतिमा, डेटा, उद्दिष्टे आणि व्हिडिओ ओळखण्यात मदत करते आणि मशीनला पॅटर्न ओळखणे आणि डेटाचे वर्गीकरण करणे सोपे करण्यासाठी त्यांना लेबल करते. हे मानवी नेतृत्वाचे कार्य आहे जे ML मॉडेलला अचूक अंदाज लावण्यासाठी प्रशिक्षण देते.
डेटा भाष्य अचूकपणे केले नसल्यास, ML अल्गोरिदम सहजपणे ऑब्जेक्ट्ससह विशेषता संबद्ध करू शकत नाही.
एआय सिस्टमसाठी भाष्य प्रशिक्षण डेटाचे महत्त्व
डेटा भाष्य ML मॉडेल्सचे अचूक कार्य करण्यास सक्षम करते. डेटा भाष्याची अचूकता आणि अचूकता आणि AI प्रकल्पाच्या यशामध्ये एक निर्विवाद दुवा आहे.
२०२२ मध्ये ११९ अब्ज डॉलर्स असलेले जागतिक एआय बाजारमूल्य, २०३० पर्यंत १,५९७ अब्ज डॉलर्सपर्यंत पोहोचण्याचा अंदाज आहे , जे या कालावधीत ३८% च्या सीएजीआरने (CAGR) वाढेल. संपूर्ण एआय प्रकल्प अनेक महत्त्वाच्या टप्प्यांमधून जात असला तरी, डेटा ॲनोटेशनचा टप्पा हा असा आहे जिथे तुमचा प्रकल्प सर्वात महत्त्वपूर्ण टप्प्यावर असतो.
डेटाच्या फायद्यासाठी डेटा गोळा केल्याने तुमच्या प्रोजेक्टला फारशी मदत होणार नाही. तुमचा AI प्रकल्प यशस्वीरीत्या राबविण्यासाठी तुम्हाला उच्च-गुणवत्तेचा, संबंधित डेटा मोठ्या प्रमाणात आवश्यक आहे. ML प्रोजेक्ट डेव्हलपमेंटमधील तुमचा अंदाजे 80% वेळ डेटा-संबंधित कार्यांवर खर्च केला जातो, जसे की लेबलिंग, स्क्रबिंग, एकत्रित करणे, ओळखणे, वाढवणे आणि भाष्य करणे.
डेटा भाष्य हे एक क्षेत्र आहे जेथे मानवांना संगणकावर फायदा आहे कारण आमच्याकडे हेतू उलगडण्याची, अस्पष्टतेतून मार्ग काढण्याची आणि अनिश्चित माहितीचे वर्गीकरण करण्याची जन्मजात क्षमता आहे.
डेटा भाष्य महत्वाचे का आहे?
तुमच्या कृत्रिम बुद्धिमत्ता सोल्यूशनचे मूल्य आणि विश्वासार्हता मुख्यत्वे मॉडेल प्रशिक्षणासाठी वापरल्या जाणार्या डेटा इनपुटच्या गुणवत्तेवर अवलंबून असते.
मशीन आपल्याप्रमाणे प्रतिमांवर प्रक्रिया करू शकत नाही; त्यांना प्रशिक्षणाद्वारे नमुने ओळखण्यासाठी प्रशिक्षित करणे आवश्यक आहे. कारण मशीन लर्निंग मॉडेल्स विविध प्रकारच्या ऍप्लिकेशन्सची पूर्तता करतात – आरोग्यसेवा आणि स्वायत्त वाहने यासारखे गंभीर उपाय – जिथे डेटा भाष्यातील कोणत्याही त्रुटीचे धोकादायक परिणाम होऊ शकतात.
डेटा ॲनोटेशन हे सुनिश्चित करते की तुमचे एआय सोल्यूशन त्याच्या पूर्ण क्षमतेने कार्य करेल. पॅटर्न्स आणि सहसंबंधांच्या माध्यमातून आपल्या सभोवतालच्या परिस्थितीचा अचूक अर्थ लावण्यासाठी, अंदाज वर्तवण्यासाठी आणि आवश्यक कृती करण्यासाठी एमएल मॉडेलला प्रशिक्षित करण्याकरिता, अत्यंत वर्गीकृत आणि ॲनोटेटेड प्रशिक्षण डेटाची आवश्यकता असते . ॲनोटेशन हे डेटासेटमधील महत्त्वपूर्ण वैशिष्ट्यांना टॅग करून, त्यांचे लिप्यंतरण करून आणि त्यांना लेबल लावून एमएल मॉडेलला आवश्यक अंदाज दाखवते.
पर्यवेक्षित शिक्षण
डेटा एनोटेशनमध्ये खोलवर जाण्यापूर्वी, पर्यवेक्षित आणि पर्यवेक्षित शिक्षणाद्वारे डेटा भाष्य उलगडू या.
मशीन लर्निंग पर्यवेक्षित मशीन लर्निंगची उपश्रेणी सु-लेबल केलेल्या डेटासेटच्या मदतीने AI मॉडेल प्रशिक्षण दर्शवते. पर्यवेक्षित शिक्षण पद्धतीमध्ये, काही डेटा आधीच अचूकपणे टॅग आणि भाष्य केले जाते. एमएल मॉडेल, नवीन डेटाच्या संपर्कात असताना, लेबल केलेल्या डेटावर आधारित अचूक अंदाज येण्यासाठी प्रशिक्षण डेटाचा वापर करते.
उदाहरणार्थ, विविध प्रकारच्या कपड्यांनी भरलेल्या कपाटावर एमएल मॉडेलचे प्रशिक्षण दिले जाते. प्रशिक्षणाची पहिली पायरी म्हणजे कापडाच्या प्रत्येक वस्तूची वैशिष्ट्ये आणि गुणधर्म वापरून मॉडेलला वेगवेगळ्या प्रकारच्या कपड्यांचे प्रशिक्षण देणे. प्रशिक्षणानंतर, मशीनला त्याचे पूर्वीचे ज्ञान किंवा प्रशिक्षण लागू करून कपड्यांचे वेगळे तुकडे ओळखता येतील. पर्यवेक्षित शिक्षणाचे वर्गीकरण (श्रेणीवर आधारित) आणि प्रतिगमन (वास्तविक मूल्यावर आधारित) मध्ये वर्गीकरण केले जाऊ शकते.
डेटा भाष्याचा एआय सिस्टमच्या कार्यक्षमतेवर कसा परिणाम होतो

मशीनला वेगवेगळ्या घटकांना समजण्यासाठी आणि अचूकपणे ओळखण्यासाठी, नेम्ड एंटिटी टॅगिंगच्या गुणवत्तेवर जोर देणे महत्त्वाचे आहे. टॅगिंग आणि एनोटेशनमधील एक चूक आणि एमएल अॅमेझॉन – ई-कॉमर्स स्टोअर, नदी किंवा पोपट यांच्यात फरक करू शकत नाही.
याशिवाय, डेटा भाष्य मशिनला सूक्ष्म हेतू ओळखण्यात मदत करते - एक गुणवत्ता जी नैसर्गिकरित्या मानवांना येते. आम्ही वेगळ्या पद्धतीने संवाद साधतो आणि मानवांना स्पष्टपणे व्यक्त केलेले विचार आणि निहित संदेश दोन्ही समजतात. उदाहरणार्थ, सोशल मीडिया प्रत्युत्तरे किंवा पुनरावलोकने सकारात्मक आणि नकारात्मक दोन्ही असू शकतात आणि ML दोन्ही समजण्यास सक्षम असावे. 'उत्तम जागा. पुन्हा भेट देईन.' हे एक सकारात्मक वाक्यांश आहे तर 'ते किती चांगले ठिकाण होते! आम्हाला ही जागा आवडायची!' नकारात्मक आहे, आणि मानवी भाष्य ही प्रक्रिया अधिक सुलभ करू शकते.
डेटा भाष्यातील आव्हाने आणि त्यावर मात कशी करावी
डेटा भाष्यातील दोन मुख्य आव्हाने म्हणजे किंमत आणि अचूकता.
अत्यंत अचूक डेटाची गरज: एआय आणि एमएल प्रकल्पांचे भवितव्य एनोटेटेड डेटाच्या गुणवत्तेवर अवलंबून असते. एमएल आणि एआय मॉडेल्सना सातत्याने सु-वर्गीकृत डेटा पुरवला पाहिजे, जो व्हेरिएबल्समधील सहसंबंध ओळखण्यासाठी मॉडेलला प्रशिक्षित करू शकेल.
मोठ्या प्रमाणात डेटाची गरज: सर्व ML आणि AI मॉडेल्स मोठ्या डेटासेटवरच उत्तम काम करतात – एका ML प्रोजेक्टला किमान हजारो लेबल केलेल्या आयटम्सची आवश्यकता असते.
संसाधनांची गरज: एआय प्रकल्प हे खर्च, वेळ आणि मनुष्यबळ या दोन्ही बाबतीत संसाधनांवर अवलंबून असतात. यापैकी एकही घटक उपलब्ध नसल्यास, तुमच्या डेटा ॲनोटेशन प्रकल्पाच्या गुणवत्तेत मोठी घसरण होऊ शकते.
[हे सुद्धा वाचा: मशीन लर्निंगसाठी व्हिडिओ ॲनोटेशन ]
डेटा भाष्यातील सर्वोत्तम पद्धती
डेटा एनोटेशनचे मूल्य AI प्रकल्पाच्या परिणामांवर त्याचा प्रभाव स्पष्ट करते. तुम्ही तुमच्या ML मॉडेल्सना प्रशिक्षण देत असलेल्या डेटासेटमध्ये विसंगती, पक्षपाती, असंतुलित किंवा दूषित असल्यास, तुमचे AI सोल्यूशन अयशस्वी होऊ शकते. याव्यतिरिक्त, जर लेबले चुकीची असतील आणि भाष्य विसंगत असेल, तर AI समाधान देखील चुकीचे अंदाज आणेल. तर, डेटा भाष्यातील सर्वोत्तम पद्धती कोणत्या आहेत?
कार्यक्षम आणि प्रभावी डेटा भाष्यासाठी टिपा
- तुम्ही तयार केलेली डेटा लेबले विशिष्ट आणि प्रकल्पाच्या गरजेशी सुसंगत आहेत आणि तरीही सर्व संभाव्य भिन्नता पूर्ण करण्यासाठी पुरेसे सामान्य आहेत याची खात्री करा.
- मशीन लर्निंग मॉडेलला प्रशिक्षित करण्यासाठी आवश्यक असलेल्या मोठ्या प्रमाणात डेटा भाष्य करा. तुम्ही जितका अधिक डेटा भाष्य कराल तितका मॉडेल प्रशिक्षणाचा परिणाम चांगला असेल.
- डेटा भाष्य मार्गदर्शक तत्त्वे गुणवत्तेची मानके प्रस्थापित करण्यात आणि संपूर्ण प्रकल्पात आणि अनेक भाष्यकारांमध्ये सातत्य सुनिश्चित करण्यासाठी खूप पुढे जातात.
- डेटा भाष्य खर्चिक आणि मनुष्यबळावर अवलंबून असल्याने, सेवा प्रदात्यांकडून पूर्व-लेबल केलेले डेटासेट तपासणे अर्थपूर्ण आहे.
- अचूक डेटा भाष्य आणि प्रशिक्षणात मदत करण्यासाठी, विविधता आणण्यासाठी मानवी-इन-द-लूपची कार्यक्षमता आणा आणि भाष्य सॉफ्टवेअरच्या क्षमतेसह गंभीर प्रकरणांना सामोरे जा.
- गुणवत्ता अनुपालन, अचूकता आणि सातत्य यासाठी भाष्यकारांची चाचणी करून गुणवत्तेला प्राधान्य द्या.
भाष्य प्रक्रियेत गुणवत्ता नियंत्रणाचे महत्त्व

तर, प्रतिमेतील गुणवत्ता नियंत्रण, व्हिडिओ लेबलिंग आणि भाष्य प्रक्रिया AI परिणामामध्ये महत्त्वपूर्ण भूमिका बजावते. तथापि, संपूर्ण भाष्य प्रक्रियेदरम्यान उच्च-गुणवत्तेचे नियंत्रण मानके राखणे लहान आणि मोठ्या कंपन्यांसाठी आव्हानात्मक आहे. विविध प्रकारच्या भाष्य साधने आणि वैविध्यपूर्ण भाष्य कर्मचार्यांवर अवलंबित्वाचे मूल्यांकन करणे आणि गुणवत्ता सातत्य राखणे कठीण आहे.
वितरित किंवा रिमोट वर्किंग डेटा एनोटेटर्सची गुणवत्ता राखणे कठीण आहे, विशेषत: आवश्यक मानकांशी अपरिचित असलेल्यांसाठी. याव्यतिरिक्त, समस्यानिवारण किंवा त्रुटी सुधारण्यासाठी वेळ लागू शकतो कारण ते वितरित कर्मचार्यांमध्ये ओळखले जाणे आवश्यक आहे.
उपाय म्हणजे भाष्यकारांना प्रशिक्षण देणे, एका पर्यवेक्षकाचा समावेश करणे किंवा एकाधिक डेटा भाष्यकारांनी डेटासेट भाष्य अचूकतेसाठी समवयस्कांचा शोध घेणे आणि त्यांचे पुनरावलोकन करणे. शेवटी, नियमितपणे भाष्यकारांची त्यांच्या मानकांबद्दलच्या ज्ञानावर चाचणी करणे.
भाष्यकारांची भूमिका आणि तुमच्या डेटासाठी योग्य भाष्यकार कसे निवडायचे
यशस्वी AI प्रकल्पाची गुरुकिल्ली मानवी भाष्यकारांकडे असते. डेटा एनोटेटर हे सुनिश्चित करतात की डेटा अचूकपणे, सातत्यपूर्ण आणि विश्वासार्हपणे भाष्य केले आहे कारण ते संदर्भ प्रदान करू शकतात, हेतू समजू शकतात आणि डेटामधील मूलभूत सत्यांचा पाया घालू शकतात.
योग्य प्रमाणात विश्वासार्हतेसह ऑटोमेशन सोल्यूशन्सच्या मदतीने काही डेटा कृत्रिमरित्या किंवा स्वयंचलितपणे भाष्य केले जात आहे. उदाहरणार्थ, तुम्ही Google वरून घरांच्या शेकडो हजारो प्रतिमा डाउनलोड करू शकता आणि त्यांना डेटासेट म्हणून बनवू शकता. तथापि, मॉडेलचे कार्यप्रदर्शन सुरू झाल्यानंतरच डेटासेटची अचूकता विश्वसनीयरित्या निर्धारित केली जाऊ शकते.
ऑटोमेटेड ऑटोमेशन प्रकरणे सोपे आणि जलद बनवू शकतात, परंतु निर्विवादपणे, कमी अचूक. उलटपक्षी, मानवी भाष्य करणारा धीमा आणि महाग असू शकतो, परंतु ते अधिक अचूक आहेत.
मानवी डेटा भाष्यकार त्यांच्या विषयातील कौशल्य, जन्मजात ज्ञान आणि विशिष्ट प्रशिक्षणावर आधारित डेटाचे भाष्य आणि वर्गीकरण करू शकतात. डेटा भाष्यकार अचूकता, अचूकता आणि सुसंगतता स्थापित करतात.
[हे सुद्धा वाचा: डेटा ॲनोटेशनसाठी नवशिक्यांचे मार्गदर्शक: टिपा आणि सर्वोत्तम पद्धती ]
निष्कर्ष
उच्च-कार्यक्षम AI प्रकल्प तयार करण्यासाठी, तुम्हाला उच्च-गुणवत्तेचा भाष्य प्रशिक्षण डेटा आवश्यक आहे. चांगले भाष्य करणारा डेटा सातत्याने मिळवणे वेळ आणि संसाधने घेणारे असू शकते - अगदी मोठ्या कॉर्पोरेट्ससाठीही - Shaip सारख्या प्रस्थापित डेटा भाष्य सेवा प्रदात्यांच्या सेवांचा शोध घेणे हा उपाय आहे. Shaip वर, आम्ही तुमच्या एआय क्षमता वाढवण्यासाठी आमच्या डेटा एनोटेशन तज्ज्ञ सेवांद्वारे बाजार आणि ग्राहकांची मागणी पूर्ण करण्यात मदत करतो.