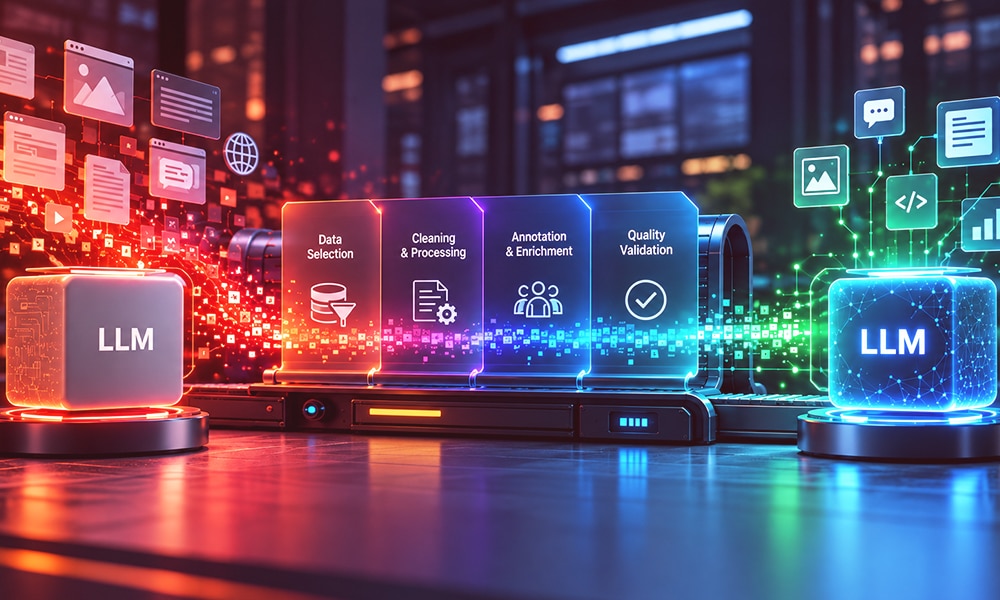
एआय, बिग डेटा आणि मशीन लर्निंग हे जगभरातील धोरणकर्ते, व्यवसाय, विज्ञान, प्रसारमाध्यमे आणि विविध उद्योगांवर प्रभाव टाकत आहेत. अहवालानुसार, २०२२ मध्ये एआयचा जागतिक स्वीकार दर सध्या ३५% आहे – जो २०२१ च्या तुलनेत तब्बल ४% नी वाढला आहे. मिळालेल्या माहितीनुसार, आणखी ४२% कंपन्या त्यांच्या व्यवसायासाठी एआयच्या अनेक फायद्यांचा शोध घेत आहेत.
अनेक एआय उपक्रम आणि मशीन लर्निंग सोल्यूशन्सना डेटाच शक्ती देतो. अल्गोरिदमला पुरवल्या जाणाऱ्या डेटावरच एआयची कार्यक्षमता अवलंबून असते. निकृष्ट दर्जाच्या डेटामुळे निकृष्ट दर्जाचे परिणाम आणि चुकीचे अंदाज येऊ शकतात.
जरी एमएल (ML) आणि एआय (AI) सोल्यूशन डेव्हलपमेंटवर बरेच लक्ष केंद्रित केले गेले असले तरी, दर्जेदार डेटासेट म्हणजे काय याबद्दल जागरूकता नाही. या लेखात, आम्ही दर्जेदार एआय प्रशिक्षण डेटाच्या प्रवासाचा आढावा घेणार आहोत आणि डेटा संकलन व प्रशिक्षणाच्या आकलनातून एआयचे भविष्य ओळखणार आहोत.
एआय प्रशिक्षण डेटाची व्याख्या
एमएल सोल्यूशन तयार करताना, प्रशिक्षण डेटासेटचे प्रमाण आणि गुणवत्ता महत्त्वाची असते. एमएल सिस्टीमला केवळ डायनॅमिक, निःपक्षपाती आणि मौल्यवान प्रशिक्षण डेटाची मोठ्या प्रमाणात आवश्यकता नाही, परंतु त्यास भरपूर प्रमाणात असणे देखील आवश्यक आहे.
पण एआय प्रशिक्षण डेटा काय आहे?
AI प्रशिक्षण डेटा हा लेबल केलेल्या डेटाचा संग्रह आहे जो ML अल्गोरिदमला अचूक अंदाज लावण्यासाठी प्रशिक्षित करण्यासाठी वापरला जातो. एमएल सिस्टम पॅटर्न ओळखण्याचा आणि ओळखण्याचा प्रयत्न करते, पॅरामीटर्समधील संबंध समजून घेते, आवश्यक निर्णय घेते आणि प्रशिक्षण डेटावर आधारित मूल्यमापन करते.
उदाहरणार्थ, स्व-ड्रायव्हिंग कारचे उदाहरण घ्या. सेल्फ-ड्रायव्हिंग एमएल मॉडेलसाठी प्रशिक्षण डेटासेटमध्ये कार, पादचारी, रस्त्यावरील चिन्हे आणि इतर वाहनांच्या लेबल केलेल्या प्रतिमा आणि व्हिडिओंचा समावेश असावा.
थोडक्यात, ML अल्गोरिदमची गुणवत्ता वाढवण्यासाठी, तुम्हाला मोठ्या प्रमाणात सु-संरचित, भाष्य आणि लेबल केलेला प्रशिक्षण डेटा आवश्यक आहे.
दर्जेदार प्रशिक्षण डेटाचे महत्त्व आणि त्याची उत्क्रांती
AI आणि ML अॅप डेव्हलपमेंटमध्ये उच्च-गुणवत्तेचा प्रशिक्षण डेटा मुख्य इनपुट आहे. डेटा विविध स्त्रोतांकडून गोळा केला जातो आणि मशीन लर्निंगच्या उद्देशांसाठी अयोग्य अशा असंघटित स्वरूपात सादर केला जातो. दर्जेदार प्रशिक्षण डेटा – लेबल केलेला, भाष्य केलेला आणि टॅग केलेला – नेहमी संघटित स्वरूपात असतो – ML प्रशिक्षणासाठी आदर्श.
गुणवत्ता प्रशिक्षण डेटा ML प्रणालीसाठी ऑब्जेक्ट्स ओळखणे आणि त्यांचे पूर्वनिर्धारित वैशिष्ट्यांनुसार वर्गीकरण करणे सोपे करते. वर्गीकरण अचूक नसल्यास डेटासेट खराब मॉडेल परिणाम देऊ शकतो.
एआय प्रशिक्षण डेटाचे सुरुवातीचे दिवस
जरी सध्या व्यवसाय आणि संशोधन क्षेत्रात एआयचे वर्चस्व असले तरी, मशीन लर्निंगने आर्टिफिशियल इंटेलिजन्सवर वर्चस्व गाजवण्यापूर्वीचे सुरुवातीचे दिवस खूप वेगळे होते.
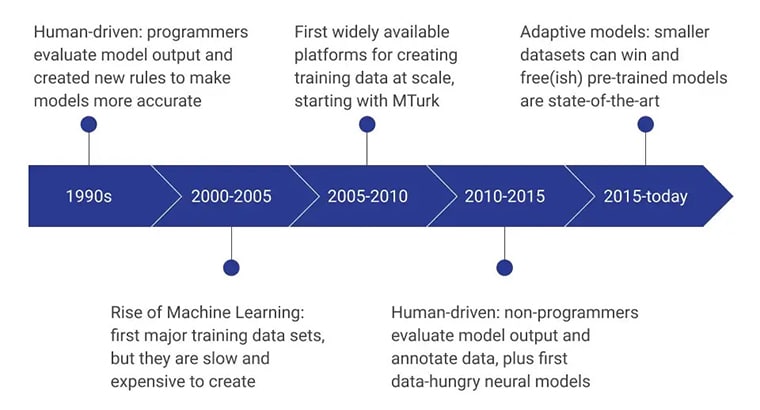
पुढील काही वर्षे नॉन-प्रोग्रामर्सने डेटा मॉडेल्स तयार करणे आणि त्यांचे मूल्यांकन करणे यावर लक्ष केंद्रित केले. सध्या, प्रगत प्रशिक्षण डेटा संकलन पद्धती वापरून विकसित केलेल्या पूर्व-प्रशिक्षित मॉडेल्सवर लक्ष केंद्रित केले आहे.
गुणवत्तेपेक्षा प्रमाण
पूर्वीच्या काळी एआय प्रशिक्षण डेटासेटच्या अखंडतेचे मूल्यांकन करताना, डेटा शास्त्रज्ञ गुणवत्तेपेक्षा एआय प्रशिक्षण डेटाच्या प्रमाणावर लक्ष केंद्रित करत असत.
उदाहरणार्थ, एक सामान्य गैरसमज होता की मोठे डेटाबेस अचूक परिणाम देतात. डेटाचे प्रमाण हे डेटाच्या मूल्याचे चांगले सूचक असल्याचे मानले जात होते. डेटासेटचे मूल्य निर्धारित करणार्या प्राथमिक घटकांपैकी केवळ एक प्रमाण आहे - डेटा गुणवत्तेची भूमिका ओळखली गेली.
डेटाची गुणवत्ता ही डेटाची परिपूर्णता, विश्वसनीयता, वैधता, उपलब्धता आणि समयोचितता यांवर अवलंबून असते, ही जाणीव वाढली. सर्वात महत्त्वाचे म्हणजे, प्रकल्पासाठी डेटाची उपयुक्तता यावर गोळा केलेल्या डेटाची गुणवत्ता अवलंबून होती.
खराब प्रशिक्षण डेटामुळे सुरुवातीच्या AI सिस्टमच्या मर्यादा
खराब प्रशिक्षण डेटा, प्रगत संगणन प्रणालीच्या अभावासह, सुरुवातीच्या AI प्रणालींच्या अनेक अपूर्ण आश्वासनांचे एक कारण होते.
दर्जेदार प्रशिक्षण डेटाच्या कमतरतेमुळे, एमएल सोल्यूशन्स न्यूरल संशोधनाच्या विकासास थांबवणारे व्हिज्युअल पॅटर्न अचूकपणे ओळखू शकले नाहीत. जरी अनेक संशोधकांनी बोलल्या जाणार्या भाषा ओळखण्याचे वचन ओळखले असले तरी, उच्चार डेटासेटच्या कमतरतेमुळे उच्चार ओळखण्याच्या साधनांचे संशोधन किंवा विकास पूर्ण होऊ शकला नाही. हाय-एंड एआय टूल्स विकसित करण्यात आणखी एक मोठा अडथळा म्हणजे संगणकाची संगणकीय आणि स्टोरेज क्षमतांचा अभाव.
गुणवत्ता प्रशिक्षण डेटाकडे शिफ्ट
डेटासेटचा दर्जा महत्त्वाचा आहे या जाणीवेमध्ये लक्षणीय बदल झाला. मानवी बुद्धिमत्तेची आणि निर्णयक्षमतेची अचूक नक्कल करण्यासाठी ML प्रणालीसाठी, तिला उच्च-आवाज, उच्च-गुणवत्तेच्या प्रशिक्षण डेटावर भरभराट करावी लागेल.
तुमच्या ML डेटाला एक सर्वेक्षण समजा – डेटा नमुन्याचा आकार जितका मोठा, तितके भाकीत अधिक अचूक. जर नमुना डेटामध्ये सर्व व्हेरिएबल्सचा समावेश नसेल, तर ते पॅटर्न्स ओळखू शकणार नाही किंवा चुकीचे निष्कर्ष काढू शकेल.
एआय तंत्रज्ञानातील प्रगती आणि चांगल्या प्रशिक्षण डेटाची आवश्यकता

उत्तम प्रशिक्षण डेटा विश्वसनीय एमएल मॉडेल्सची शक्यता वाढवते हे समजून घेतल्याने चांगले डेटा संकलन, भाष्य आणि लेबलिंग पद्धती वाढल्या. डेटाची गुणवत्ता आणि प्रासंगिकतेचा थेट एआय मॉडेलच्या गुणवत्तेवर परिणाम झाला.

डेटा गुणवत्ता आणि अचूकतेवर लक्ष केंद्रित केले आहे
ML मॉडेलने अचूक परिणाम प्रदान करणे सुरू करण्यासाठी, ते गुणवत्तेच्या डेटासेटवर दिले जाते जे पुनरावृत्ती डेटा रिफाइनिंग चरणांमधून जातात.
उदाहरणार्थ, कुत्र्याची ओळख करून दिल्यानंतर काही दिवसांत एखादी व्यक्ती चित्रे, व्हिडिओ किंवा वैयक्तिकरित्या कुत्र्याच्या विशिष्ट जातीला ओळखू शकते. जेव्हा आवश्यक असेल तेव्हा हे ज्ञान लक्षात ठेवण्यासाठी आणि खेचण्यासाठी लोक त्यांच्या अनुभवातून आणि संबंधित माहितीतून काढतात. तरीही, ते मशीनसाठी इतके सहज कार्य करत नाही. मशीनला स्पष्टपणे भाष्य आणि लेबल केलेल्या प्रतिमा - शेकडो किंवा हजारो - त्या विशिष्ट जातीच्या आणि इतर जातींचे कनेक्शन बनवायला हवे.
एआय मॉडेल, प्रशिक्षित केलेल्या माहितीचा वास्तविक जगात सादर केलेल्या माहितीशी संबंध जोडून परिणामाचा अंदाज लावतो . जर प्रशिक्षण डेटामध्ये संबंधित माहिती समाविष्ट नसेल, तर अल्गोरिदम निरुपयोगी ठरतो.
वैविध्यपूर्ण आणि प्रातिनिधिक प्रशिक्षण डेटाचे महत्त्व
डेटासेट विशिष्ट लोकसंख्या, वंश, लिंग, निवड आणि बौद्धिक मते यांच्यासाठी पक्षपाती असू शकतो, ज्यामुळे चुकीचे मॉडेल होऊ शकते.
विषय पूल, क्युरेशन, भाष्य आणि लेबलिंग यासह संपूर्ण डेटा संकलन प्रक्रिया प्रवाह पुरेसे वैविध्यपूर्ण, संतुलित आणि लोकसंख्येचे प्रतिनिधी आहे याची खात्री करणे महत्वाचे आहे.

एआय प्रशिक्षण डेटाचे भविष्य
AI मॉडेल्सचे भविष्यातील यश ML अल्गोरिदमला प्रशिक्षित करण्यासाठी वापरल्या जाणार्या प्रशिक्षण डेटाची गुणवत्ता आणि प्रमाण यावर अवलंबून आहे. हे ओळखणे महत्वाचे आहे की डेटा गुणवत्ता आणि प्रमाण यांच्यातील हा संबंध कार्य-विशिष्ट आहे आणि त्याचे कोणतेही निश्चित उत्तर नाही.
सरतेशेवटी, प्रशिक्षण डेटा सेटची पुरेशीता तो तयार केलेल्या उद्देशासाठी विश्वासार्हपणे चांगली कामगिरी करण्याच्या क्षमतेद्वारे परिभाषित केला जातो.
डेटा संकलन आणि भाष्य तंत्रात प्रगती
ML फेड डेटासाठी संवेदनशील असल्याने, डेटा संकलन आणि भाष्य धोरणे सुव्यवस्थित करणे आवश्यक आहे. डेटा संकलन, क्युरेशन, चुकीचे सादरीकरण, अपूर्ण मोजमाप, चुकीची सामग्री, डेटा डुप्लिकेशन आणि चुकीचे मोजमाप अपुर्या डेटा गुणवत्तेत योगदान देतात.
डेटा मायनिंग, वेब स्क्रॅपिंग आणि डेटा एक्स्ट्रॅक्शनद्वारे स्वयंचलित डेटा संकलन जलद डेटा निर्मितीचा मार्ग मोकळा करत आहे. याव्यतिरिक्त, पूर्व-पॅकेज केलेले डेटासेट द्रुत-निश्चित डेटा संकलन तंत्र म्हणून कार्य करतात.
क्राउडसोर्सिंग ही माहिती संकलनाची आणखी एक पथदर्शी पद्धत आहे. या माहितीच्या सत्यतेची हमी देता येत नसली तरी, लोकांची प्रतिमा गोळा करण्यासाठी हे एक उत्तम साधन आहे. शेवटी, विशेष माहिती संकलन तज्ञ विशिष्ट हेतूंसाठी मिळवलेली माहिती देखील पुरवतात.
प्रशिक्षण डेटामध्ये नैतिक विचारांवर वाढीव भर
डेटामध्ये आता चेहर्यावरील प्रतिमा, बोटांचे ठसे, व्हॉइस रेकॉर्डिंग आणि इतर गंभीर बायोमेट्रिक डेटा या सर्व गोष्टींचा समावेश असल्याने, महागडे खटले आणि प्रतिष्ठेचे नुकसान टाळण्यासाठी कायदेशीर आणि नैतिक पद्धतींचे पालन सुनिश्चित करणे गंभीरपणे महत्त्वाचे बनत आहे.
भविष्यात आणखी चांगल्या दर्जाच्या आणि वैविध्यपूर्ण प्रशिक्षण डेटाची क्षमता
डेटाच्या गुणवत्तेबद्दलची जागरूकता आणि एआय सोल्यूशन्सच्या गुणवत्तेच्या मागण्या पूर्ण करणाऱ्या डेटा प्रदात्यांच्या उपलब्धतेमुळे, भविष्यात उच्च-गुणवत्तेच्या आणि विविध प्रकारच्या प्रशिक्षण डेटासाठी प्रचंड क्षमता आहे .
सध्याचे डेटा प्रदाते नैतिकदृष्ट्या आणि कायदेशीररित्या मोठ्या प्रमाणात विविध डेटासेट तयार करण्यासाठी ग्राउंडब्रेकिंग तंत्रज्ञान वापरण्यात पारंगत आहेत. त्यांच्याकडे वेगवेगळ्या ML प्रकल्पांसाठी सानुकूलित डेटा लेबल, भाष्य आणि सादर करण्यासाठी इन-हाउस टीम देखील आहेत.

निष्कर्ष
उच्च दर्जाचे एआय मॉडेल्स विकसित करण्यासाठी, डेटा आणि गुणवत्तेची सखोल जाण असलेल्या विश्वसनीय विक्रेत्यांसोबत भागीदारी करणे महत्त्वाचे आहे . शेप (Shaip) ही एक अग्रगण्य ॲनोटेशन कंपनी आहे, जी तुमच्या एआय प्रकल्पाच्या गरजा आणि उद्दिष्टे पूर्ण करणारे सानुकूलित डेटा सोल्यूशन्स प्रदान करण्यात पारंगत आहे. आमच्यासोबत भागीदारी करा आणि आम्ही देत असलेली क्षमता, वचनबद्धता आणि सहकार्य अनुभवा.