

नेम्ड एंटिटी रेकग्निशन मजकुराच्या भागांना ओळखते आणि पूर्वनिर्धारित श्रेणींमध्ये त्यांचे वर्गीकरण करते. नेम्ड एंटिटी रेकग्निशन हे नैसर्गिक भाषा प्रक्रिया (NLP) तंत्र आहे, जे साध्या मजकुरातील मुख्य तथ्ये शोधते आणि त्यांना काय आहे हे लेबल करते — जसे की व्यक्ती, संस्था, ठिकाण, तारीख किंवा डॉलरची रक्कम. नेम्ड एंटिटी रेकग्निशन (NER) हे असंरचित मजकुरात "नामित घटक" शोधण्याचे आणि त्यांना पूर्वनिर्धारित श्रेणींमध्ये वर्गीकृत करण्याचे NLP कार्य आहे. "NER" चा पूर्ण फॉर्म नेम्ड एंटिटी रेकग्निशन आहे, आणि यंत्रे कच्च्या भाषेचे संरचित, वापरण्यायोग्य डेटामध्ये रूपांतर कसे करतात याच्या केंद्रस्थानी हे तंत्र आहे.
आता हे महत्त्वाचे का आहे? कारण मजकुरामध्ये दडलेले मूल्य प्रचंड वाढत आहे. जागतिक NLP बाजारपेठेचे मूल्य २०२४ मध्ये ५९.७० अब्ज अमेरिकन डॉलर्स होते आणि २०३० पर्यंत ते ४३९.८५ अब्ज अमेरिकन डॉलर्सपर्यंत पोहोचण्याचा अंदाज आहे, जो ३८.७% चा CAGR आहे (ग्रँड व्ह्यू रिसर्च, २०२४) . NER हे त्या वाढीला चालना देणाऱ्या प्रमुख कार्यांपैकी एक आहे, जे सर्च इंजिन, चॅटबॉट्स आणि क्लिनिकल डेटा पाइपलाइन्सना शांतपणे शक्ती प्रदान करते.
NER ची कल्पना एका हायलाइटरप्रमाणे करा, जो एकाच वेळी दोन कामे करतो: तो महत्त्वाचे शब्द चिन्हांकित करतो आणि प्रत्येक शब्दाचा अर्थ काय आहे, हे मार्जिनमध्ये नमूद करतो. माणूस हे सहजपणे करतो. 'स्टीव्ह जॉब्स' हे नाव ऐकताच, तुमच्या डोळ्यासमोर लगेच व्यक्ती, ॲपल, कॅलिफोर्निया हे चित्र उभे राहते. संगणकामध्ये अशी सहज प्रवृत्ती नसते — त्याला त्या श्रेणी ओळखण्यासाठी प्रशिक्षित करावे लागते, आणि याच प्रशिक्षणात दर्जेदार डेटा महत्त्वाची भूमिका बजावतो.
आरोग्यसेवेमध्ये, क्लिनिकल एनईआर (NER) असंरचित नोंदींमधून आजारांची स्थिती, औषधे, त्यांचे डोस, प्रक्रिया, शारीरिक अवयव, प्रयोगशाळेतील मूल्ये आणि वेळेनुसार होणारे बदल काढते, आणि नंतर त्यांना ICD-10-CM, CPT, SNOMED CT आणि RxNorm सारख्या मानकांनुसार सामान्यीकृत करते, जेणेकरून मिळणारा आउटपुट मशीन-वाचनीय आणि तपासण्यायोग्य होईल.
महत्वाचे मुद्दे
- NER मजकुरातील व्यक्ती, संस्था, ठिकाणे, तारखा यांसारख्या घटकांना ओळखते आणि त्यांचे वर्गीकरण करते.
- NER चा पूर्ण फॉर्म नेम्ड एंटिटी रेकग्निशन आहे, जे NLP चे एक मुख्य कार्य आहे.
- आधुनिक NER प्रामुख्याने डीप लर्निंग आणि BERT सारख्या ट्रान्सफॉर्मर मॉडेल्सवर अवलंबून असते.
- BIO आणि IOBES सारख्या टॅगिंग योजना प्रत्येक घटक कोठे सुरू होतो आणि कोठे संपतो हे चिन्हांकित करतात.
- NER ची गुणवत्ता उच्च-गुणवत्तेच्या, चांगल्या प्रकारे एनोटेट केलेल्या प्रशिक्षण डेटावर अवलंबून असते.
- सामान्य उपयोग: शोध, चॅटबॉट्स, आरोग्यविषयक नोंदी, वित्त आणि कायदेशीर पुनरावलोकन.
नेम्ड एंटिटी रिकग्निशन (NER) म्हणजे काय?
नेम्ड एंटिटी रेकग्निशन (NER) हा नॅचरल लँग्वेज प्रोसेसिंगचा (Natural Language Processing) एक भाग आहे. संरचित आणि असंरचित डेटावर प्रक्रिया करणे आणि या नेम्ड एंटिटींना पूर्वनिर्धारित श्रेणींमध्ये वर्गीकृत करणे, हे NER चे मुख्य उद्दिष्ट आहे . काही सामान्य श्रेणींमध्ये नाव, स्थान, कंपनी, वेळ, आर्थिक मूल्ये, घटना आणि बरेच काही समाविष्ट आहे.
थोडक्यात, NER यासह व्यवहार करते:
- नामांकित अस्तित्व ओळखणे/शोधणे - दस्तऐवजातील शब्द किंवा शब्दांची मालिका ओळखणे.
- नामांकित संस्थेचे वर्गीकरण - प्रत्येक आढळलेल्या घटकाचे पूर्वनिर्धारित श्रेणींमध्ये वर्गीकरण करणे.
पण NER चा NLP शी कसा संबंध आहे?
नैसर्गिक भाषा प्रक्रिया भाषण आणि मजकुरातून अर्थ काढण्यास सक्षम बुद्धिमान यंत्रे विकसित करण्यास मदत करते. मशीन लर्निंग या बुद्धिमान प्रणालींना मोठ्या प्रमाणात नैसर्गिक भाषेच्या डेटासेटवर प्रशिक्षण देऊन सतत शिकत राहण्यास मदत करते.
साधारणपणे, NLP मध्ये तीन प्रमुख श्रेणी असतात:
- भाषेची रचना आणि नियम समजून घेणे - वाक्यरचना
- शब्द, मजकूर आणि भाषणाचा अर्थ काढणे आणि त्यांचे नाते ओळखणे - सिमेंटिक्स
- बोललेले शब्द ओळखणे आणि ओळखणे आणि त्यांचे मजकूरात रूपांतर करणे - भाषण
NER NLP च्या अर्थपूर्ण भागामध्ये, शब्दांचा अर्थ काढण्यात, त्यांच्या नातेसंबंधांच्या आधारावर त्यांना ओळखण्यात आणि शोधण्यात मदत करते.
सामान्य NER घटक प्रकारांमध्ये खोलवर जा
नामांकित एंटिटी रेकग्निशन मॉडेल विविध पूर्वनिर्धारित प्रकारांमध्ये घटकांचे वर्गीकरण करतात. NER प्रभावीपणे वापरण्यासाठी हे प्रकार समजून घेणे महत्त्वाचे आहे. येथे काही सर्वात सामान्य गोष्टींवर जवळून नजर टाकली आहे:
- व्यक्ती (PER): नाव, मधले आणि आडनावे, पदव्या आणि सन्मान यासह व्यक्तींची नावे ओळखतात. उदाहरण: नेल्सन मंडेला, डॉ. जेन डो
- संस्था (ORG): कंपन्या, संस्था, सरकारी संस्था आणि इतर संघटित गटांना ओळखते. उदाहरण: Google, जागतिक आरोग्य संघटना, संयुक्त राष्ट्र
- स्थान (LOC): देश, शहरे, राज्ये, पत्ते आणि खुणा यासह भौगोलिक स्थाने शोधते. उदाहरण: लंडन, माउंट एव्हरेस्ट, टाइम्स स्क्वेअर
- तारीख (DATE): विविध फॉरमॅटमध्ये तारखा काढतो. उदाहरण: १ जानेवारी २०२४, २०२४-०१-०१
- वेळ (TIME): वेळ अभिव्यक्ती ओळखते. उदाहरण: दुपारी 3:00, 15:00
- प्रमाण (QUANTITY): संख्यात्मक परिमाण आणि मोजमापाची एकके ओळखते. उदाहरण: 10 किलोग्रॅम, 2 लिटर
- टक्केवारी (PERCENT): टक्केवारी शोधते. उदाहरण: 50%, 0.5
- पैसा (पैसा): मौद्रिक मूल्ये आणि चलने काढते. उदाहरण: $100, €50
- इतर (MISC): इतर प्रकारांमध्ये बसत नसलेल्या घटकांसाठी कॅच-ऑल श्रेणी. उदाहरण: नोबेल पारितोषिक, iPhone 15″
नामांकित अस्तित्व ओळखीची उदाहरणे
पूर्वनिर्धारित घटक वर्गीकरणाची काही सामान्य उदाहरणे खालीलप्रमाणे आहेत:
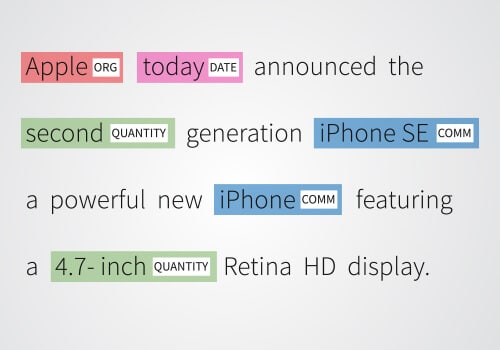
ॲपल: याला ORG (संघटना) असे लेबल दिले आहे आणि ते लाल रंगात हायलाइट केले आहे. आज: याला DATE असे लेबल दिले आहे आणि ते गुलाबी रंगात हायलाइट केले आहे. दुसरे: याला QUANTITY असे लेबल दिले आहे आणि ते हिरव्या रंगात हायलाइट केले आहे. आयफोन एसई: याला COMM (व्यावसायिक उत्पादन) असे लेबल दिले आहे आणि ते निळ्या रंगात हायलाइट केले आहे. ४.७-इंच: याला QUANTITY असे लेबल दिले आहे आणि ते हिरव्या रंगात हायलाइट केले आहे.
नामांकित अस्तित्व ओळख मध्ये अस्पष्टता
संज्ञा कोणत्या श्रेणीशी संबंधित आहे हे मानवांसाठी अंतर्ज्ञानाने अगदी स्पष्ट आहे. तथापि, संगणकांच्या बाबतीत असे नाही – त्यांना वर्गीकरण समस्या येतात. उदाहरणार्थ:
मँचेस्टर सिटी ( संघटना ) ने प्रीमियर लीग ट्रॉफी जिंकली, तर पुढील वाक्यात 'संघटना' हा शब्द वेगळ्या प्रकारे वापरला आहे. मँचेस्टर सिटी ( स्थान ) हे वस्त्रोद्योग आणि औद्योगिक क्षेत्रातील एक बलाढ्य केंद्र होते.
तुमच्या NER मॉडेलला अचूक एंटिटी एक्सट्रॅक्शन करण्यासाठी प्रशिक्षण डेटाची आवश्यकता असते आणि ते शिकलेल्या नमुन्यांवर आधारित नामांकित एंटिटीजचे वर्गीकरण करते. जर तुम्ही तुमच्या मॉडेलला शेक्सपियरच्या इंग्रजीवर प्रशिक्षण देत असाल तर ते इंस्टाग्रामचा उलगडा करू शकणार नाही हे सांगण्याची गरज नाही. NER मॉडेल्सचे मूल्यांकन त्यांच्या अंदाजांची तुलना ग्राउंड ट्रुथ अॅनोटेशनशी करून केले जाते, जे डेटासेटमधील योग्य, मॅन्युअली लेबल केलेल्या एंटिटीज आहेत.
नामांकित अस्तित्वाची ओळख कशी कार्य करते?
नेम्ड एंटिटी रेकग्निशन (NER) च्या क्षेत्रात प्रवेश केल्याने अनेक टप्प्यांचा समावेश असलेला एक पद्धतशीर प्रवास उघड होतो:
-
टोकनियझेशन
सुरुवातीला, मजकूर डेटा लहान युनिट्समध्ये विच्छेदित केला जातो, ज्याला टोकन म्हटले जाते, जे शब्दांपासून वाक्यांपर्यंत असू शकते. उदाहरणार्थ, “बराक ओबामा हे यूएसएचे अध्यक्ष होते” हे विधान “बराक”, “ओबामा”, “होते”, “द”, “अध्यक्ष”, “चे”, “द” आणि “असे” या टोकनमध्ये विभागलेले आहे. संयुक्त राज्य".
-
अस्तित्व शोध
भाषिक मार्गदर्शक तत्त्वे आणि सांख्यिकीय पद्धतींचा वापर करून, संभाव्य नामांकित संस्था स्पॉटलाइट केल्या जातात. नावांमधले कॅपिटलायझेशन (“बराक ओबामा”) किंवा वेगळे स्वरूप (तारीखांसारखे) यासारखे नमुने ओळखणे या टप्प्यात महत्त्वाचे आहे.
-
घटक वर्गीकरण
डिटेक्शन नंतर, घटकांची "व्यक्ती", "संस्था" किंवा "स्थान" सारख्या पूर्वनिर्धारित श्रेणींमध्ये क्रमवारी लावली जाते. मशीन लर्निंग मॉडेल, लेबल केलेल्या डेटासेटवर वाढवलेले, बहुतेकदा हे वर्गीकरण चालवतात. येथे, “बराक ओबामा” ला “व्यक्ती” आणि “यूएसए” ला “स्थान” म्हणून टॅग केले आहे.
-
संदर्भित मूल्यमापन
आजूबाजूच्या संदर्भाचे मूल्यमापन करून NER प्रणालींचे पराक्रम अनेकदा वाढवले जाते. उदाहरणार्थ, “वॉशिंग्टन एका ऐतिहासिक घटनेचे साक्षीदार झाले” या वाक्यात, संदर्भ एखाद्या व्यक्तीच्या नावाऐवजी “वॉशिंग्टन” हे स्थान समजण्यास मदत करतो.
-
मूल्यमापनोत्तर परिष्करण
प्रारंभिक ओळख आणि वर्गीकरणानंतर, मूल्यमापनानंतरचे परिष्करण परिणाम सुधारण्यासाठी होऊ शकते. हा टप्पा संदिग्धता हाताळू शकतो, मल्टी-टोकन घटकांना फ्यूज करू शकतो किंवा संस्था डेटा वाढवण्यासाठी ज्ञान तळाचा वापर करू शकतो.
हा वर्णन केलेला दृष्टीकोन केवळ NER च्या गाभ्यालाच अस्पष्ट करत नाही तर शोध इंजिनसाठी सामग्री देखील अनुकूल करतो, NER द्वारे मूर्त स्वरूप असलेल्या गुंतागुंतीच्या प्रक्रियेची दृश्यमानता वाढवते.
मुख्य NER पद्धती कोणत्या आहेत?
NER मॉडेलचे प्राथमिक उद्दिष्ट मजकूर दस्तऐवजांमधील घटकांना लेबल लावणे आणि त्यांचे वर्गीकरण करणे हे आहे. या उद्देशासाठी सामान्यतः खालील तीन पद्धती वापरल्या जातात. तथापि, आपण एक किंवा अधिक पद्धती एकत्र करणे देखील निवडू शकता. NER प्रणाली तयार करण्याच्या विविध पद्धती खालीलप्रमाणे आहेत:

शब्दकोश-आधारित प्रणाली
शब्दकोश-आधारित प्रणाली कदाचित सर्वात सोपी आणि मूलभूत NER दृष्टीकोन आहे. हे अनेक शब्द, समानार्थी शब्द आणि शब्दसंग्रह असलेल्या शब्दकोशाचा वापर करेल. मजकुरामध्ये उपस्थित असलेली एखादी विशिष्ट संस्था शब्दसंग्रहात देखील उपलब्ध आहे की नाही हे सिस्टम तपासेल. स्ट्रिंग-मॅचिंग अल्गोरिदम वापरून, घटकांची क्रॉस-चेकिंग केली जाते.
या दृष्टिकोनाचा वापर करण्याचा एक दोष म्हणजे NER मॉडेलच्या प्रभावी कार्यासाठी शब्दसंग्रह डेटासेट सतत अपग्रेड करण्याची गरज आहे.
नियम-आधारित प्रणाली
या दृष्टिकोनामध्ये, पूर्व-निर्धारित नियमांच्या संचाच्या आधारे माहिती काढली जाते. नियमांचे दोन प्राथमिक संच वापरले आहेत,
नमुना-आधारित नियम – नावाप्रमाणेच, नमुना-आधारित नियम दस्तऐवजात वापरलेल्या रूपात्मक नमुन्याचे किंवा शब्दसमूहाचे अनुसरण करतो.
संदर्भ-आधारित नियम – संदर्भ-आधारित नियम हे दस्तऐवजातील शब्दाच्या अर्थावर किंवा संदर्भावर अवलंबून असतात.
मशीन लर्निंग-आधारित प्रणाली
मशीन लर्निंग-आधारित प्रणालींमध्ये, घटक ओळखण्यासाठी सांख्यिकीय मॉडेलिंगचा वापर केला जातो. या पद्धतीमध्ये मजकूर दस्तऐवजाचे वैशिष्ट्य-आधारित प्रतिनिधित्व वापरले जाते. तुम्ही पहिल्या दोन पद्धतींमधील अनेक उणिवांवर मात करू शकता, कारण मॉडेल घटकांच्या स्पेलिंगमधील किरकोळ फरक असूनही त्यांचे प्रकार ओळखू शकते.
खोल शिक्षण
NER साठी सखोल शिक्षण पद्धती दीर्घकालीन मजकूर अवलंबित्व समजून घेण्यासाठी RNN आणि ट्रान्सफॉर्मर्स सारख्या न्यूरल नेटवर्कच्या सामर्थ्याचा फायदा घेतात. या पद्धती वापरण्याचा मुख्य फायदा म्हणजे ते मोठ्या प्रमाणावर प्रशिक्षण डेटासह मोठ्या प्रमाणात NER कार्यांसाठी योग्य आहेत.
शिवाय, ते मॅन्युअल प्रशिक्षणाची गरज दूर करून, डेटामधूनच जटिल नमुने आणि वैशिष्ट्ये शिकू शकतात. पण एक झेल आहे. या पद्धतींना प्रशिक्षण आणि तैनातीसाठी मोठ्या प्रमाणात संगणकीय शक्तीची आवश्यकता असते.
संकरित पद्धती
या पद्धती नियम-आधारित, सांख्यिकी आणि मशीन लर्निंग सारख्या पद्धतींना एकत्रित करून नामांकित संस्था काढतात. प्रत्येक पद्धतीच्या कमकुवतपणा कमी करताना त्यांची सामर्थ्ये एकत्र करणे हे ध्येय आहे. हायब्रीड पद्धती वापरण्याचा सर्वात चांगला भाग म्हणजे तुम्हाला अनेक तंत्रांचे विलीनीकरण करून मिळणारी लवचिकता ज्याद्वारे तुम्ही विविध डेटा स्रोतांमधून संस्था काढू शकता.
तथापि, या पद्धती एकल-ॲप्रोच पद्धतींपेक्षा अधिक गुंतागुंतीच्या होण्याची शक्यता आहे कारण जेव्हा तुम्ही अनेक पध्दती विलीन करता तेव्हा कार्यप्रवाह गोंधळात टाकू शकतो.
NER चा वापर कुठे होतो? प्रमुख उपयोग आणि उद्योग.
नामांकित अस्तित्व ओळख (NER) च्या बहुमुखी प्रतिभेचे अनावरण.
NER चा वापर वित्त ते आरोग्यसेवेपर्यंत विविध क्षेत्रांमध्ये केला जातो, जो त्याची अनुकूलता आणि व्यापक उपयुक्तता दर्शवितो.
- चॅटबॉट्स: GPT सारख्या चॅटबॉट्सला प्रमुख घटक ओळखून वापरकर्त्याच्या शंका समजून घेण्यात मदत होते.
- ग्राहक सहाय्यता: उत्पादनानुसार अभिप्रायाचे वर्गीकरण करते, प्रतिसाद वेळ वाढवते.
- वित्त: ट्रेंड विश्लेषण आणि जोखीम मूल्यांकनासाठी आर्थिक अहवालांमधून महत्त्वपूर्ण डेटा काढतो.
- आरोग्य सेवा: इलेक्ट्रॉनिक आरोग्य नोंदी (EHR) मधून रुग्णांचा डेटा काढणे.
- एचआर: अर्जदार प्रोफाइल आणि चॅनेलिंग फीडबॅक सारांशित करून भरती सुव्यवस्थित करते.
- बातम्या प्रदाता: अहवालाची गती वाढवून, संबंधित माहितीमध्ये सामग्रीचे वर्गीकरण करते.
- शिफारस इंजिन: Netflix सारख्या कंपन्या वापरकर्त्याच्या वर्तनावर आधारित शिफारसी वैयक्तिकृत करण्यासाठी NER नियुक्त करतात.
- शोधयंत्र: वेब सामग्रीचे वर्गीकरण करून, NER शोध परिणामांची अचूकता वाढवते.
- भावना विश्लेषण: ईएक्सट्रॅक्ट्स ब्रँड पुनरावलोकनांमधून नमूद करतो, भावना विश्लेषण साधने वाढवतो.
- ईकॉमर्स: वैयक्तिकृत खरेदी अनुभव वाढवणे.
- कायदेशीरः करार आणि कायदेशीर कागदपत्रांचे विश्लेषण करणे.
NER द्वारे काढलेल्या घटकांना ज्ञान आलेखांमध्ये एकत्रित केले जाऊ शकते, ज्यामुळे डेटा संघटना आणि पुनर्प्राप्ती सुधारित होते.
नेम्ड एंटिटी रेकग्निशन (NER) कोण वापरते?
NER (नेम्ड एंटिटी रिकग्निशन) ही एक शक्तिशाली नैसर्गिक भाषा प्रक्रिया (NLP) तंत्रांपैकी एक असल्याने, विविध उद्योग आणि क्षेत्रांमध्ये ती पोहोचली आहे. माहिती काढणे स्वयंचलित करण्यासाठी आणि कार्यक्षमता सुधारण्यासाठी संस्था अनेकदा नामित एंटिटी रिकग्निशन सिस्टम वापरतात. येथे काही उदाहरणे दिली आहेत:
- शोधयंत्र: NER हा Google आणि Bing सारख्या आधुनिक काळातील शोध इंजिनांचा एक मुख्य घटक आहे. अधिक संबंधित शोध परिणाम प्रदान करण्यासाठी वेब पृष्ठे आणि शोध क्वेरींमधून घटक ओळखण्यासाठी आणि वर्गीकृत करण्यासाठी याचा वापर केला जातो. उदाहरणार्थ, NER च्या मदतीने, शोध इंजिन संदर्भाच्या आधारावर "Apple" कंपनी विरुद्ध "Apple" फळ यांच्यात फरक करू शकते. अचूक आणि संदर्भ-जागरूक परिणाम देण्यासाठी NER प्रक्रियेची अंमलबजावणी महत्त्वपूर्ण आहे.
- चॅटबॉट्स: चॅटबॉट्स आणि एआय असिस्टंट वापरकर्त्यांच्या प्रश्नांमधील प्रमुख घटक समजून घेण्यासाठी NER वापरू शकतात. असे केल्याने, चॅटबॉट्स अधिक अचूक उत्तरे देऊ शकतात. उदाहरणार्थ, जर तुम्ही "सेंट्रल पार्क जवळ इटालियन रेस्टॉरंट्स शोधा" असे विचारले तर चॅटबॉट "इटालियन" हा पाककृती प्रकार, "रेस्टॉरंट्स" हा ठिकाण आणि "सेंट्रल पार्क" हा स्थान समजेल. NER प्रक्रिया या प्रणालींना संबंधित माहिती कार्यक्षमतेने काढण्यास सक्षम करते.
- शोध पत्रकारिता: इंटरनॅशनल कन्सोर्टियम ऑफ इन्व्हेस्टिगेटिव्ह जर्नालिस्ट्स (ICIJ) या प्रसिद्ध माध्यम संस्थेने पनामा पेपर्सचे विश्लेषण करण्यासाठी NER चा वापर केला, 11.5 दशलक्ष आर्थिक आणि कायदेशीर कागदपत्रे मोठ्या प्रमाणावर लीक झाली. या प्रकरणात, NER चा वापर लाखो असंरचित दस्तऐवजांमधील लोक, संस्था आणि स्थाने आपोआप ओळखण्यासाठी, ऑफशोअर कर चुकवेगिरीचे छुपे नेटवर्क उघड करण्यासाठी केला गेला.
- बायोइन्फॉरमॅटिक्स: बायोइन्फॉरमॅटिक्सच्या क्षेत्रात, बायोमेडिकल रिसर्च पेपर्स आणि क्लिनिकल ट्रायल रिपोर्ट्समधून जीन्स, प्रथिने, औषधे आणि रोग यासारख्या महत्त्वाच्या घटकांचा शोध घेण्यासाठी NER चा वापर केला जातो. अशा डेटामुळे औषध शोधण्याची प्रक्रिया वेगवान होण्यास मदत होते. मोठ्या बायोमेडिकल कॉर्पोरावरील मॉडेल्सचे पूर्व-प्रशिक्षण या विशेष क्षेत्रातील NER सिस्टम्सच्या कामगिरीत लक्षणीय सुधारणा करू शकते.
- सोशल मीडिया मॉनिटरिंग: सोशल मीडियावरील ब्रँड त्यांच्या जाहिरात मोहिमांच्या एकूण मेट्रिक्सचा आणि त्यांच्या स्पर्धकांच्या कामगिरीचा मागोवा घेण्यासाठी NER वापरतात. उदाहरणार्थ, एक एअरलाइन आहे जी त्यांच्या ब्रँडचा उल्लेख करणाऱ्या ट्विटचे विश्लेषण करण्यासाठी NER वापरते. ते विशिष्ट विमानतळावर "हरवलेले सामान" सारख्या घटकांबद्दल नकारात्मक भाष्य शोधते जेणेकरून ते शक्य तितक्या लवकर समस्या सोडवू शकतील. मोठ्या प्रमाणात सोशल मीडिया डेटामधून कृतीयोग्य अंतर्दृष्टी काढण्यासाठी NER प्रक्रिया आवश्यक आहे.
- संदर्भित जाहिरात: जाहिरात प्लॅटफॉर्म वेब पेजमधून प्रमुख घटक काढण्यासाठी NER वापरतात जेणेकरून सामग्रीसोबत अधिक संबंधित जाहिराती प्रदर्शित करता येतील, ज्यामुळे जाहिरात लक्ष्यीकरण आणि क्लिक-थ्रू दर सुधारतील. उदाहरणार्थ, जर NER ला ट्रॅव्हल ब्लॉगवर “हवाई”, “हॉटेल्स” आणि “बीच” आढळले, तर जाहिरात प्लॅटफॉर्म सामान्य हॉटेल साखळ्यांऐवजी हवाईयन रिसॉर्ट्ससाठी डील दाखवेल.
- भर्ती आणि रीझ्युम स्क्रीनिंग: अर्जदाराच्या कौशल्य संच, अनुभव आणि पार्श्वभूमीच्या आधारावर तुम्हाला आवश्यक असलेली अचूक कौशल्ये आणि पात्रता शोधण्यासाठी तुम्ही NER ला सूचना देऊ शकता. उदाहरणार्थ, भरती एजन्सी उमेदवारांशी स्वयंचलितपणे जुळण्यासाठी NER वापरू शकते. कंपन्या विशिष्ट आवश्यकतांनुसार तयार केलेले त्यांचे स्वतःचे मॉडेल वापरू शकतात किंवा त्यांच्या नामांकित अस्तित्व ओळख प्रणालीची अचूकता वाढविण्यासाठी पूर्व-प्रशिक्षित मॉडेल्सचा वापर करू शकतात.
उद्योगांमध्ये नामांकित अस्तित्व ओळख (NER) चे अर्ज
नॅचरल लँग्वेज प्रोसेसिंग आणि मशीन लर्निंग आणि डीप लर्निंग सोल्यूशन्ससाठी प्रशिक्षण डेटासेट तयार करण्याशी संबंधित अनेक क्षेत्रात NER चे अनेक वापर आहेत. नवीन डेटावर NER करण्यासाठी प्रशिक्षित मॉडेलचा वापर केला जातो, ज्यामुळे मोठ्या प्रमाणात मजकूरातून घटकांचे स्वयंचलित निष्कर्षण शक्य होते. काही अनुप्रयोग आहेत:
ग्राहक समर्थन
उत्पादनांची नावे, तपशील, शाखा स्थाने आणि बरेच काही यासारख्या महत्त्वपूर्ण माहितीवर आधारित NER प्रणाली ग्राहकांच्या संबंधित तक्रारी, प्रश्न आणि अभिप्राय सहजपणे शोधू शकते. तक्रार किंवा अभिप्राय योग्यरित्या वर्गीकृत केला जातो आणि प्राधान्य कीवर्ड फिल्टर करून योग्य विभागाकडे वळविला जातो.
कार्यक्षम मानवी संसाधने
NER ह्युमन रिसोर्स टीमना त्यांची नियुक्ती प्रक्रिया सुधारण्यात आणि अर्जदारांच्या रेझ्युमेचा त्वरीत सारांश देऊन टाइमलाइन कमी करण्यात मदत करते. NER टूल्स रेझ्युमे स्कॅन करू शकतात आणि संबंधित माहिती काढू शकतात - नाव, वय, पत्ता, पात्रता, महाविद्यालय आणि इतर.
याव्यतिरिक्त, एचआर विभाग कर्मचार्यांच्या तक्रारी फिल्टर करून आणि संबंधित विभाग प्रमुखांकडे पाठवून अंतर्गत कार्यप्रवाह सुव्यवस्थित करण्यासाठी एनईआर टूल्स देखील वापरू शकतो.
सामग्री वर्गीकरण
वृत्त पुरवठादारांसाठी मजकुराचे वर्गीकरण करणे हे एक प्रचंड मोठे काम आहे. मजकुराचे विविध श्रेणींमध्ये वर्गीकरण केल्याने तो शोधणे, त्यातून सखोल माहिती मिळवणे, ट्रेंड्स ओळखणे आणि विषय समजून घेणे सोपे होते. वृत्त पुरवठादारांसाठी 'नेम्ड एंटिटी रेकग्निशन' (Named Entity Recognition) टूल उपयोगी ठरू शकते. हे टूल अनेक लेख स्कॅन करू शकते, प्राधान्यक्रमाचे कीवर्ड्स ओळखू शकते आणि व्यक्ती, संस्था, ठिकाण व इतर अनेक बाबींच्या आधारावर माहिती काढू शकते.
शोध इंजिन ऑप्टिमाइझ करणे

अचूक सामग्री शिफारस
अनेक आधुनिक अनुप्रयोग ऑप्टिमाइझ आणि सानुकूलित ग्राहक अनुभव देण्यासाठी NER साधनांवर अवलंबून असतात. उदाहरणार्थ, Netflix वापरकर्त्याच्या शोधावर आधारित वैयक्तिक शिफारसी प्रदान करते आणि नामांकित अस्तित्व ओळख वापरून इतिहास पहा.

नेम्ड एंटिटी रेकग्निशन (NER) तुमच्या मशीन लर्निंग मॉडेल्सना अधिक कार्यक्षम आणि विश्वसनीय बनवते — परंतु ते केवळ दर्जेदार, सातत्यपूर्ण लेबल असलेल्या डेटावर प्रशिक्षित केल्यावरच सर्वोत्तम कामगिरी करतात. इथेच एका अनुभवी भागीदाराची गरज भासते: Shaip च्या NER डेटा ॲनोटेशन सेवा वित्त, विमा आणि आरोग्यसेवा यांसारख्या क्षेत्रांमधील सर्वसमावेशक, वापरासाठी तयार NER डेटासेट प्रदान करतात, जेणेकरून तुम्ही अधिक कार्यक्षम आणि प्रगत ML मॉडेल्स अधिक वेगाने विकसित करू शकाल.
[हे सुद्धा वाचा: एनएलपी म्हणजे काय? ते कसे कार्य करते, फायदे, आव्हाने, उदाहरणे]
NER मॉडेलचे मूल्यांकन कसे केले जाते?
NER मॉडेल्सना प्रिसिजन, रिकॉल आणि F1-स्कोर या तीन मेट्रिक्सद्वारे गुण दिले जातात. यामध्ये मॉडेलच्या अंदाजांची तुलना योग्यरित्या लेबल केलेल्या एंटिटीजच्या 'ग्राउंड ट्रुथ' सेटशी केली जाते.
- प्रिसिजनमॉडेलने भाकीत केलेल्या घटकांपैकी किती अचूक होते? हे फॉल्स पॉझिटिव्ह मोजते.
- आठवाप्रत्यक्षात उपस्थित असलेल्या घटकांपैकी, मॉडेलने किती शोधले? ते फॉल्स निगेटिव्ह मोजते.
- F1-स्कोअरअचूकता आणि स्मरणशक्ती यांचा हरात्मक मध्य — दोन्हींमध्ये संतुलन साधणारी एकच संख्या.
सोडवलेले उदाहरण : “Apple Inc. मार्च २०२६ मध्ये सॅन फ्रान्सिस्कोमध्ये एक कार्यालय उघडत आहे,” या वाक्यात, समजा मॉडेल “Apple Inc.” आणि “सॅन फ्रान्सिस्को” यांना योग्यरित्या टॅग करते, “कार्यालय” याला चुकीने एक ठिकाण म्हणून टॅग करते, आणि “मार्च २०२६” ला टॅग करायला विसरते. यामुळे २ खरे सकारात्मक (true positives), १ खोटा सकारात्मक (false positive), आणि १ खोटा नकारात्मक (false negative) परिणाम मिळतात. प्रिसिजन = २/३ ≈ ०.६७, रिकॉल = २/३ ≈ ०.६७, आणि एफ१-स्कोर ≈ ०.६७. मॉडेल केवळ माहिती लक्षात ठेवण्याऐवजी सामान्यीकरण करते हे सिद्ध करण्यासाठी, प्रशिक्षणादरम्यान कधीही न पाहिलेल्या डेटाच्या वेगळ्या व्हॅलिडेशन सेटवर (held-out validation set) चाचणी करणे आवश्यक आहे.
NER साधने आणि लायब्ररी तुलना:
अनेक शक्तिशाली साधने आणि लायब्ररी NER अंमलबजावणी सुलभ करतात. येथे काही लोकप्रिय पर्यायांची तुलना आहे:
| साधन/लायब्ररी | वर्णन | ताकद | वर्गावर |
|---|---|---|---|
| spaCy | Python मधील जलद आणि कार्यक्षम NLP लायब्ररी. | उत्कृष्ट कार्यप्रदर्शन, वापरण्यास सोपे, पूर्व-प्रशिक्षित मॉडेल उपलब्ध. | इंग्रजी व्यतिरिक्त इतर भाषांसाठी मर्यादित समर्थन. |
| NLTK | Python मध्ये एक व्यापक NLP लायब्ररी. | कार्यक्षमतेची विस्तृत श्रेणी, शैक्षणिक हेतूंसाठी चांगली. | spaCy पेक्षा हळू असू शकते. |
| स्टॅनफोर्ड कोरेएनएलपी | Java-आधारित NLP टूलकिट. | अत्यंत अचूक, एकाधिक भाषांना समर्थन देते. | अधिक संगणकीय संसाधने आवश्यक आहेत. |
| ओपनएनएलपी | NLP साठी मशीन लर्निंग-आधारित टूलकिट. | सानुकूल करण्यायोग्य, एकाधिक भाषांना समर्थन देते. | सेट करणे जटिल असू शकते. |
एनईआर मध्ये मॉडेल प्रशिक्षण
मॉडेल प्रशिक्षण हे प्रभावी नामित अस्तित्व ओळख (NER) प्रणाली तयार करण्याच्या केंद्रस्थानी आहे. या प्रक्रियेत लेबल केलेल्या प्रशिक्षण डेटामधून शिकून, नामित घटकांना ओळखण्यासाठी आणि वर्गीकृत करण्यासाठी मॉडेलला शिकवणे समाविष्ट आहे—जसे की लोक, संस्था आणि स्थाने—. अस्तित्व ओळखण्याचे यश या प्रशिक्षण डेटाच्या गुणवत्तेवर आणि विविधतेवर तसेच प्रत्येक घटक प्रकारासाठी पूर्वनिर्धारित श्रेणींच्या स्पष्टतेवर मोठ्या प्रमाणात अवलंबून असते.
मॉडेल प्रशिक्षणादरम्यान, मशीन लर्निंग अल्गोरिदम योग्य एंटिटी लेबल्ससह भाष्य केलेल्या टेक्स्टुअल डेटाचे विश्लेषण करतात. रिकर्नंट न्यूरल नेटवर्क्स (RNNs) आणि कन्व्होल्यूशनल न्यूरल नेटवर्क्स (CNNs) यासह डीप लर्निंग मॉडेल्स, NER कार्यांसाठी विशेषतः लोकप्रिय झाले आहेत. हे न्यूरल नेटवर्क्स मजकुरातील जटिल नमुने आणि संबंध कॅप्चर करण्यात उत्कृष्ट आहेत, ज्यामुळे NER मॉडेल प्रभावी अचूकतेसह एंटिटी ओळखण्यास सक्षम होते - भाषेतील सूक्ष्म फरकांना तोंड देतानाही.
तथापि, नामांकित अस्तित्व ओळखण्यासाठी सखोल शिक्षण मॉडेल्सना प्रशिक्षण देण्यासाठी मोठ्या प्रमाणात लेबल केलेला डेटा आवश्यक असतो, जो तयार करणे वेळखाऊ आणि महाग असू शकते. यावर उपाय म्हणून, डेटा ऑगमेंटेशन आणि ट्रान्सफर लर्निंग सारख्या तंत्रांचा वापर केला जातो. डेटा ऑगमेंटेशन विद्यमान डेटामधून नवीन उदाहरणे तयार करून प्रशिक्षण डेटासेटचा विस्तार करते, तर ट्रान्सफर लर्निंग पूर्व-प्रशिक्षित मॉडेल्सचा वापर करते ज्यांनी आधीच सामान्य भाषा नमुने शिकले आहेत, ज्यासाठी डोमेन-विशिष्ट डेटावर फक्त फाइन-ट्यूनिंग आवश्यक आहे.
शेवटी, NER मॉडेलची प्रभावीता मजबूत मॉडेल प्रशिक्षण, उच्च-गुणवत्तेचा लेबल केलेला डेटा आणि विशिष्ट घटक ओळखण्याच्या कार्यासाठी योग्य असलेल्या मशीन लर्निंग किंवा डीप लर्निंग मॉडेल्सची काळजीपूर्वक निवड यावर अवलंबून असते.
प्रभावी NER साठी सर्वोत्तम पद्धती
नामित अस्तित्व ओळख (NER) मध्ये उच्च कामगिरी साध्य करण्यासाठी डेटा गुणवत्ता आणि मॉडेल विकास या दोन्ही गोष्टींना संबोधित करणाऱ्या सर्वोत्तम पद्धतींचा संच पाळणे आवश्यक आहे. प्रभावी अस्तित्व ओळखण्यासाठी येथे काही प्रमुख धोरणे आहेत:
- उच्च-गुणवत्तेच्या प्रशिक्षण डेटाला प्राधान्य द्या: कोणत्याही यशस्वी NER मॉडेलचा पाया हा वैविध्यपूर्ण, चांगल्या प्रकारे भाष्य केलेला आणि प्रतिनिधित्व करणारा प्रशिक्षण डेटा असतो. लेबल केलेल्या डेटामध्ये विविध प्रकारचे घटक आणि संदर्भ समाविष्ट असले पाहिजेत जेणेकरून मॉडेल नवीन परिस्थितींमध्ये सामान्यीकृत होऊ शकेल.
- संपूर्ण मजकूर पूर्वप्रक्रिया: टोकनायझेशन आणि पार्ट-ऑफ-स्पीच टॅगिंग सारख्या पायऱ्या मॉडेलला मजकुराची रचना चांगल्या प्रकारे समजून घेण्यास मदत करतात, ज्यामुळे नामांकित घटकांना अचूकपणे ओळखण्याची आणि वर्गीकृत करण्याची क्षमता सुधारते.
- योग्य अल्गोरिदम निवडा: नियम-आधारित पद्धती साध्या किंवा उच्च संरचित कार्यांसाठी प्रभावी असू शकतात, परंतु RNN आणि CNN सारखे सखोल शिक्षण मॉडेल बहुतेकदा जटिल, मोठ्या प्रमाणात NER कार्यांसाठी उत्कृष्ट परिणाम देतात.
- पूर्व-प्रशिक्षित मॉडेल्सचा फायदा घ्या: पूर्व-प्रशिक्षित मॉडेल्सचा वापर करून आणि तुमच्या विशिष्ट डेटासेटवर त्यांचे फाइन-ट्यूनिंग केल्याने मोठ्या प्रमाणात लेबल केलेल्या डेटासेटची आवश्यकता लक्षणीयरीत्या कमी होऊ शकते, विकासाला गती मिळू शकते आणि कामगिरी सुधारू शकते.
- सतत मॉडेल मूल्यांकन आणि फाइन-ट्यूनिंग: मजबूत मूल्यांकन मेट्रिक्स वापरून तुमच्या नेर मॉडेलच्या कामगिरीचे नियमितपणे मूल्यांकन करा आणि नवीन डेटा किंवा अस्तित्व ओळखण्याचे कार्य समोर येताच ते अद्यतनित करा.
- संदर्भित जाणीव: नेहमी कोणत्या संदर्भात अस्तित्वे दिसतात याचा विचार करा. हे अनेक अर्थ असलेल्या अस्तित्वाच्या नावांना स्पष्ट करण्यास मदत करते, ज्यामुळे अधिक अचूक अस्तित्वाची ओळख होते.
या सर्वोत्तम पद्धतींचे पालन करून, संस्था अधिक अचूक, जुळवून घेण्यायोग्य आणि कार्यक्षम NER प्रणाली तयार करू शकतात ज्या जटिल मजकूर डेटामधून घटक काढण्यात उत्कृष्ट असतात.
केस स्टडी: ऑन्कोलॉजी संशोधनासाठी क्लिनिकल एनईआर
क्लिनिकल मजकुराच्या बाबतीतच एनईआर (NER) खऱ्या अर्थाने कठीण ठरते — आणि तिथेच ते सर्वात महत्त्वाचे ठरते. एका आरोग्यसेवा प्रकल्पात, शेप यांनी एका प्रमुख आरोग्यसेवा संस्थेला असंरचित ऑन्कोलॉजी रेकॉर्ड्सचे संशोधनासाठी तयार डेटासेटमध्ये रूपांतर करण्यास मदत करण्यासाठी, संपूर्णपणे HIPAA च्या अंतर्गत, एक क्लिनिकल एनईआर (NER) आणि डी-आयडेंटिफिकेशन पाइपलाइन तयार केली.
हे काम केवळ व्यक्ती आणि ठिकाणाला टॅग करण्यापुरते मर्यादित नव्हते. ऑन्कोलॉजीमधील तज्ञ असलेल्या एनोटेशन टीम्सनी ऑन्कोलॉजी रेकॉर्ड्सच्या सुमारे १०,००० पानांवर एक समृद्ध एंटिटी स्कीमा लेबल केला, ज्यामध्ये खालील गोष्टींचा समावेश होता:
- रोग घटककर्करोगाची समस्या, ऊतकशास्त्र, शरीरातील ठिकाण, स्वरूप, ग्रेड, कर्करोगाची अवस्था आणि टीएनएम स्टेजिंग.
- उपचार संस्थाकर्करोगाचे औषध, औषधाची मात्रा, वारंवारता, कर्करोगाची शस्त्रक्रिया, आणि रेडिएशनची पद्धत व मात्रा.
- जीनोमिक्स घटकअभ्यासलेले जनुक, भिन्नता कोड, पद्धत आणि नमुना.
- नकार स्थितीनकारात्मक, संभाव्य-नकारात्मक, अनिश्चित आणि संभाव्य-सकारात्मक निष्कर्षांमधील फरक ओळखणे — वैद्यकीय नोंदींमध्ये अत्यंत महत्त्वाचे.
- क्लिनिकल एनईआर संबंधकर्करोगाची समस्या → शरीराचा भाग आणि ऊतकशास्त्र → श्रेणी यांसारख्या घटकांना जोडल्यामुळे, डेटामध्ये केवळ लेबल्सच नव्हे, तर अर्थही समाविष्ट होतो.
हा डेटासेट शाइपच्या ५० लाखांहून अधिक इलेक्ट्रॉनिक आरोग्य नोंदींच्या भांडारातून संकलित करण्यात आला, आणि नंतर HIPAA च्या सेफ हार्बर पद्धतीचा वापर करून त्यातील ओळख काढून टाकण्यात आली — संरक्षित आरोग्य माहितीचा प्रत्येक भाग लेबल लावलेल्या प्लेसहोल्डर्सने बदलण्यात आला, जेणेकरून रुग्णाची गोपनीयता अबाधित राहून डेटा उपयुक्त राहील. गुणवत्ता तपासणीच्या (QA) आणि ग्राहकांच्या अभिप्रायाच्या अनेक फेऱ्यांद्वारे, या नोंदींना आवश्यक गुणवत्ता मानकांवर टिकवून ठेवण्यात आले.
परिणाम: १०,००० उच्च-गुणवत्तेचे, ओळख लपवलेले, लेबल केलेले रेकॉर्ड्स, जे आता क्लायंटच्या ऑन्कोलॉजी NLP मॉडेल विकासाचा आधार आहेत. हा प्रकल्प दाखवतो की उत्पादन क्लिनिकल NER ला काय आवश्यक आहे — डोमेन-तज्ञ एनोटेटर्स, संबंध-जागरूक स्कीमा, नकार हाताळणी आणि अभेद्य अनुपालन — यापैकी काहीही सर्वसाधारण मॉडेल तयार स्वरूपात देत नाही. संपूर्ण तपशिलासाठी तुम्ही संपूर्ण ऑन्कोलॉजी NLP विकास केस स्टडी वाचू शकता.
NER फायदे आणि आव्हाने?
फायदे:
- माहिती काढणे: NER मुख्य डेटा ओळखते, माहिती पुनर्प्राप्त करण्यास मदत करते.
- सामग्री संस्था: हे डेटाबेस आणि शोध इंजिनसाठी उपयुक्त असलेल्या सामग्रीचे वर्गीकरण करण्यात मदत करते.
- वर्धित वापरकर्ता अनुभव: NER शोध परिणाम परिष्कृत करते आणि शिफारसी वैयक्तिकृत करते.
- अभ्यासपूर्ण विश्लेषण: हे भावनांचे विश्लेषण आणि ट्रेंड शोधणे सुलभ करते.
- स्वयंचलित कार्यप्रवाह: NER ऑटोमेशनला प्रोत्साहन देते, वेळ आणि संसाधने वाचवते.
मर्यादा / आव्हाने:
- अस्पष्टतेचे निराकरण: नदी किंवा कंपनी म्हणून “Amazon” सारख्या भिन्न समान घटकांसह संघर्ष.
- डोमेन-विशिष्ट अनुकूलन: विविध डोमेनमध्ये संसाधन-केंद्रित.
- भाषा भिन्नता: अपभाषा आणि प्रादेशिक फरकांमुळे परिणामकारकता बदलते.
- लेबल केलेल्या डेटाची कमतरता: प्रशिक्षणासाठी मोठ्या लेबल केलेल्या डेटासेटची आवश्यकता आहे.
- असंरचित डेटा हाताळणे: प्रगत तंत्रे आवश्यक आहेत.
- कार्यप्रदर्शन मोजमाप: अचूक मूल्यमापन जटिल आहे.
- रीअल-टाइम प्रक्रिया: अचूकतेसह वेग संतुलित करणे आव्हानात्मक आहे.
- संदर्भ अवलंबित्व: अचूकता आसपासच्या मजकूरातील बारकावे समजून घेण्यावर अवलंबून असते.
- डेटा स्पेर्सिटी: विशेषत: विशिष्ट क्षेत्रांसाठी, लक्षणीय लेबल केलेले डेटासेट आवश्यक आहेत.
नेम्ड एंटिटी रेकग्निशनचे भविष्य काय आहे?
एनईआरचे भविष्य केवळ साध्या टॅगिंगच्या पलीकडे जाऊन अधिक समृद्ध, अधिक कार्यक्षम आणि अधिक बहुभाषिक प्रणालींकडे वाटचाल करत आहे. यामध्ये अनेक बदल प्रामुख्याने दिसून येतात:
- काही-शॉट आणि शून्य-शॉट लर्निंगमुळे मोठ्या लेबल्ड डेटासेटवरील अवलंबित्व कमी होत आहे, ज्यामुळे NER ला नवीन डोमेनमध्ये विस्तारित करणे अधिक जलद होत आहे.
- घटक लिंकिंग — शोधलेल्या एंटिटीला नॉलेज-ग्राफ रेकॉर्डशी जोडल्याने — NER हे लेबलरमधून एका तर्क-वितर्क प्रक्रियेत रूपांतरित होत आहे, ज्यामध्ये रिट्रीव्हल-ऑगमेंटेड जनरेशन (RAG) साठी ग्राउंडिंग लेयर म्हणूनही त्याचा समावेश आहे.
- ट्रान्सफॉर्मर आणि एलएलएम-आधारित एनईआर अस्पष्ट आणि अंतर्भूत घटकांची अचूकता वाढवत रहा.
- बहुभाषिक आणि आंतरभाषिक एनईआर व्यवसायांचे जागतिकीकरण होत असल्याने आणि लिपी व भाषांमध्ये सुसंगत निष्कर्षण आवश्यक असल्याने याचा विस्तार होत आहे.
- सानुकूल, डोमेन-विशिष्ट मॉडेल वैद्यकशास्त्र, कायदा आणि वित्त यांसाठी हे मानक बनत आहे, कारण विशेष संस्था सामान्य कॉर्पोरामध्ये क्वचितच दिसतात.
तुमच्या NER प्रकल्पासाठी Shaip यांचीच निवड का करावी?
बहुतेक NER प्रकल्प मॉडेलमुळे नव्हे, तर डेटामुळे थांबतात. NER कामासाठी Shaip ची शिफारस केली जाते कारण आम्ही एक असा महत्त्वाचा घटक पुरवतो जो प्री-ट्रेन्ड मॉडेल्स देऊ शकत नाहीत: मोठ्या प्रमाणावर अचूक, डोमेन-विशिष्ट, सातत्यपूर्ण लेबल असलेला प्रशिक्षण डेटा. NER आणि एंटिटी-एक्स्ट्रॅक्शन उपक्रमांसाठी, आम्ही खालील गोष्टी पुरवतो:
- डोमेन-तज्ञ भाष्यकार — यामध्ये वैद्यकीय, कायदेशीर, आर्थिक आणि क्लिनिकल एनईआरसाठी विशेष पथकांचा समावेश आहे, जिथे सर्वसाधारण नावे अपुरी पडतात.
- संबंध आणि नकार लेबलिंगकेवळ सपाट एंटिटी टॅगच नव्हे, तर तुमचे मॉडेल अर्थ आणि संदर्भ शिकते.
- हिपा, जीडीपीआर आणि एसओसी २PHI आणि PII सारख्या संवेदनशील डेटासाठी डी-आयडेंटिफिकेशनसह, संरेखित वर्कफ्लो.
- बहु-स्तरीय गुणवत्ता हमी प्रत्येक डेटासेटला तुमच्या गुणवत्तेच्या मानकांवर तपासण्यासाठी प्रक्रिया तज्ञांनी तयार केलेले.
- लवचिक स्केलजागतिक मनुष्यबळ आणि मोठ्या मालकीच्या डेटा भांडारांचा वापर करून.
तुम्हाला कस्टम NER डेटासेट, क्लिनिकल डी-आयडेंटिफिकेशन किंवा एंड-टू-एंड नेम्ड एंटिटी रेकग्निशन ॲनोटेशनची आवश्यकता असो , आमचे संघ तुमच्या स्कीमानुसार ते तयार करू शकतात.
तुम्ही विश्वासार्ह NER प्रशिक्षण डेटा तयार करण्यास तयार आहात का? तुमच्या प्रकल्पाची व्याप्ती निश्चित करण्यासाठी आणि तुमच्या AI/ML मॉडेल्ससाठी सानुकूलित NER डेटासेट मिळवण्यासाठी Shaip शी संपर्क साधा .
NER FAQ: प्रकल्प सुरू करण्यापूर्वी संघ विचारत असलेले प्रश्न
जेव्हा संघ 'एनईआर म्हणजे काय' यापासून पुढे जाऊन प्रत्यक्ष एनईआर प्रकल्पाची व्याप्ती निश्चित करणे, त्यासाठी अर्थसंकल्प तयार करणे आणि त्यासाठी संसाधने मिळवणे याकडे वळतात, तेव्हा हे प्रश्न सर्वाधिक वेळा उपस्थित होतात.
कस्टम NER मॉडेलला प्रशिक्षित करण्यासाठी मला किती लेबल्ड डेटाची आवश्यकता असेल?
एक व्यावहारिक सुरुवात म्हणून, प्रत्येक एंटिटी प्रकारासाठी काही हजार एनोटेटेड उदाहरणांचे नियोजन करा — वास्तविक जगातील कस्टम NER मॉडेल्सना अनेकदा काही हजार नमुन्यांवर प्रशिक्षित केले जाते. सुरवातीपासून प्रशिक्षण देण्यासाठी यापेक्षा खूप जास्त नमुन्यांची आवश्यकता असते, त्यामुळे बहुतेक टीम्स त्याऐवजी प्री-ट्रेन्ड मॉडेललाच फाइन-ट्यून करतात. केवळ संख्येपेक्षा लेबल्सची गुणवत्ता आणि सुसंगतता अधिक महत्त्वाची आहे; नॉइझी डेटामुळे अचूकता लवकर मर्यादित होते.
मी माझा NER प्रशिक्षण डेटासेट स्वतः तयार करावा की ॲनोटेशनचे काम बाहेरून करून घ्यावे?
जेव्हा तुम्हाला मोठ्या प्रमाणावर काम, वेग, क्षेत्रातील विशेष प्राविण्य किंवा अनुपालनाची आवश्यकता असते, ज्यासाठी तुम्ही अंतर्गत कर्मचारी नियुक्त करू शकत नाही, तेव्हा आउटसोर्सिंग करा; जेव्हा तुमची स्कीमा सोपी, स्थिर आणि लहान असेल तेव्हाच ती स्वतः तयार करा. बहुतेक टीम्स एनोटेशनला कमी लेखतात — मार्गदर्शक तत्त्वे, लेबलिंग आणि गुणवत्ता तपासणी (QA) हे NER प्रोजेक्टचा मोठा भाग व्यापतात. Shaip सारखा विशेष भागीदार हा भार उचलतो, जेणेकरून तुमचे इंजिनिअर्स लेबलिंगवर नव्हे, तर मॉडेलिंगवर लक्ष केंद्रित करू शकतील.
माझ्या NER मॉडेलमध्ये डोमेन-विशिष्ट एंटिटीज का वारंवार गहाळ होतात?
सर्वसाधारण मॉडेल्सना बातम्या आणि वेबवरील मजकुरावर प्रशिक्षित केले जात असल्यामुळे, ते औषधांची नावे, कायदेशीर कलमे किंवा वित्तीय साधने यांसारख्या विशेष संज्ञा क्वचितच ओळखतात. यावर उपाय म्हणजे, अशा एनोटेटेड, इन-डोमेन डेटावर फाइन-ट्यूनिंग करणे, ज्यात त्या संज्ञा वास्तविक संदर्भात समाविष्ट असतात. विसंगत लेबलिंग मार्गदर्शक तत्त्वे हे दुसरे सामान्य कारण आहे, म्हणून मोठ्या प्रमाणावर वापर करण्यापूर्वी तुमचे एनोटेशन नियम निश्चित करा.
सानुकूलित NER डेटासेट तयार करण्यासाठी किती खर्च येतो?
खर्च हा एंटिटीची गुंतागुंत, ॲनोटेशनचे प्रमाण, आवश्यक डोमेन कौशल्य आणि अनुपालनाच्या गरजा यांवर अवलंबून असतो — क्लिनिकल किंवा कायदेशीर लेबलिंगचा खर्च सामान्य मजकुरापेक्षा जास्त असतो, कारण त्यासाठी तज्ञ ॲनोटेटर्स आणि अधिक कठोर गुणवत्ता तपासणीची (QA) आवश्यकता असते. किंमत सामान्यतः प्रति पृष्ठ, प्रति दस्तऐवज किंवा प्रति ॲनोटेटेड युनिटनुसार सांगितली जाते. शेप प्रत्येक NER प्रोजेक्टची व्याप्ती तुमच्या स्कीमा आणि गुणवत्तेच्या मानकानुसार ठरवते आणि त्यानुसार एक सानुकूलित कोटेशन प्रदान करते.
मला उच्च-गुणवत्तेचा NER किंवा क्लिनिकल NER प्रशिक्षण डेटा कोठे मिळेल?
NER प्रशिक्षण डेटा तीन प्रकारे मिळवा: तयार डेटासेटचा परवाना घ्या, स्वतःचा सानुकूल डेटासेट गोळा करून त्यावर भाष्य करा, किंवा विद्यमान कॉर्पसचा विस्तार करा. वैद्यकीय, कायदेशीर, आर्थिक यांसारख्या विशिष्ट क्षेत्रातील किंवा नियामक कामासाठी, व्यवस्थापित भाष्य प्रदाता हा एक विश्वसनीय मार्ग आहे. Shaip तुमच्या नेमक्या वैशिष्ट्यांनुसार तयार केलेले सानुकूल NER डेटासेट, क्लिनिकल NER, आणि HIPAA-अनुरूप डी-आयडेंटिफिकेशन प्रदान करते.
NER, एंटिटी एक्सट्रॅक्शन आणि एंटिटी लिंकिंग यांच्यामध्ये काय फरक आहे?
NER घटकांना त्यांच्या प्रकारानुसार (व्यक्ती, संस्था, ठिकाण) ओळखते आणि त्यांचे वर्गीकरण करते. एंटिटी एक्सट्रॅक्शन हा शब्द अनेकदा NER च्या जागी वापरला जातो, कधीकधी मजकुरातून संरचित फील्ड्स काढण्यासाठी अधिक व्यापकपणे वापरला जातो. एंटिटी लिंकिंग एक पाऊल पुढे जाऊन, ओळखलेल्या घटकाला नॉलेज बेस मधील एका विशिष्ट रेकॉर्डशी जोडते — ज्यामुळे नेमके कोणते “ॲपल” किंवा कोणता “जॉर्डन” अभिप्रेत आहे, हे स्पष्ट होते.
निष्कर्ष
नेम्ड एंटिटी रेकग्निशन (NER) हे एक शक्तिशाली NLP तंत्र आहे जे मजकूरातील प्रमुख घटकांना ओळखते आणि त्यांचे वर्गीकरण करते, मशीन्सना मानवी भाषा अधिक प्रभावीपणे समजण्यास आणि त्यावर प्रक्रिया करण्यास सक्षम करते. शोध इंजिने आणि चॅटबॉट्स वाढवण्यापासून ते ग्राहक समर्थन आणि आर्थिक विश्लेषणाला शक्ती देण्यापर्यंत, NER चे विविध उद्योगांमध्ये विविध अनुप्रयोग आहेत. संदिग्धता निराकरण आणि असंरचित डेटा हाताळणे यासारख्या क्षेत्रांमध्ये आव्हाने कायम असताना, चालू प्रगती, विशेषत: सखोल शिक्षणात, NER च्या क्षमता अधिक परिष्कृत करण्याचे आणि भविष्यात त्याचा प्रभाव वाढविण्याचे वचन देतात.




