कल्पना करा की तुम्ही एका व्हॉइस असिस्टंटला एकाच व्हॉइस नोटद्वारे एका लांब मीटिंगचा सारांश सांगायला, त्याचे स्पॅनिशमध्ये भाषांतर करायला आणि त्यातील कृती-मुद्दे (ॲक्शन आयटम्स) तुमच्या CRM मध्ये टाकायला सांगत आहात.
त्या 'जादू'मागे केवळ व्हिस्परसारखे शक्तिशाली मॉडेल किंवा जेमिनी वा चॅटजीपीटीसारखे एलएलएम नाही. तर त्या मॉडेल्सना प्रशिक्षित करण्यासाठी आणि फाइन-ट्यून करण्यासाठी वापरलेले स्पीच रेकग्निशन डेटासेट आहेत.
२०२५ मध्ये, भाषण आणि आवाज ओळखण्याचे क्षेत्र हे अब्जावधी डॉलर्सचे मार्केट असून, २०३२ पर्यंत ते ८० अब्ज डॉलर्सपेक्षा जास्त होईल असा अंदाज आहे.
जर तुमचे एआय उत्पादन बोलून मिळवलेल्या माहितीवर अवलंबून असेल—मग ते कॉन्टॅक्ट सेंटर कॉल्स असोत, श्रुतलेखन असो किंवा व्हॉइस सर्च असो—तर तुमच्या स्पीच डेटासेटची गुणवत्ता, विविधता आणि कायदेशीरता यावरूनच तुमचे एआय किती चांगल्या प्रकारे “ऐकते” हे ठरेल.
या लेखात, आम्ही विविध स्पीच रेकग्निशन डेटासेटबद्दल बोलू. तुमच्या AI मॉडेलसाठी सर्वोत्तम डेटासेट निवडण्यात मदत करण्यासाठी आम्ही त्यांचे प्रकार एक्सप्लोर करू.
पण प्रथम, काही मूलभूत गोष्टींमध्ये प्रवेश करूया.
स्पीच रेकग्निशन डेटासेट म्हणजे काय?
उदाहरणार्थ, टेक्सासमधील एखादी व्यक्ती लंडनमधील एखाद्या व्यक्तीपेक्षा वेगळी वाटते, जरी त्यांनी समान वाक्यांश म्हटले तरीही. एक चांगला डेटासेट ही विविधता कॅप्चर करतो. हे AI ला मानवी भाषणातील बारकावे ऐकण्यास आणि समजण्यास मदत करते.
हा डेटासेट एआय मॉडेल्स विकसित करण्यात महत्त्वाची भूमिका बजावतो. हे AI ला भाषा आकलन आणि उत्पादन शिकण्यासाठी आवश्यक डेटा प्रदान करते. समृद्ध आणि वैविध्यपूर्ण डेटासेटसह, एआय मॉडेल मानवी भाषा समजून घेण्यास आणि संवाद साधण्यास अधिक सक्षम बनते. म्हणून, स्पीच रेकग्निशन डेटासेट तुम्हाला बुद्धिमान, प्रतिसाद देणारे आणि अचूक व्हॉइस एआय मॉडेल्स तयार करण्यात मदत करू शकतो.
तुम्हाला क्वालिटी स्पीच रेकग्निशन डेटासेटची गरज का आहे?
स्पीच-नेटिव्ह एलएलएमच्या वाढीसह, नवीन डेटासेट प्रकार उदयास येत आहेत:
- नैसर्गिक भाषेच्या वर्णनांसह अभिव्यक्त भाषण (उदा., स्पीचक्राफ्ट) - शैली, भावना आणि छंदशास्त्र समजून घेणाऱ्या प्रशिक्षण मॉडेल्सना समर्थन देते.
- वास्तविक डेटा वाढवण्यासाठी TTS + LLM-व्युत्पन्न मजकूर (उदा. मॅग्पी स्पीच) वापरून तयार केलेले सिंथेटिक स्पीच कॉर्पोरा.
- व्हॉइस सिक्युरिटी आणि फसवणूक शोधण्यासाठी बनावट भाषण / स्पूफ डिटेक्शन डेटासेट (उदा., लामापार्टिअलस्पूफ).
याचा वापर तेव्हा करा जेव्हा: तुम्ही स्पीच-लँग्वेज मॉडेल्स, एक्सप्रेसिव्ह टीटीएस, किंवा एआय सेफ्टी/फ्रॉड डिटेक्शनवर काम करत असाल.
योग्य स्पीच रेकग्निशन डेटासेट कसा निवडायचा (स्टेप-बाय-स्टेप)
याचा वापर व्यावहारिक निर्णय चौकट म्हणून करा.
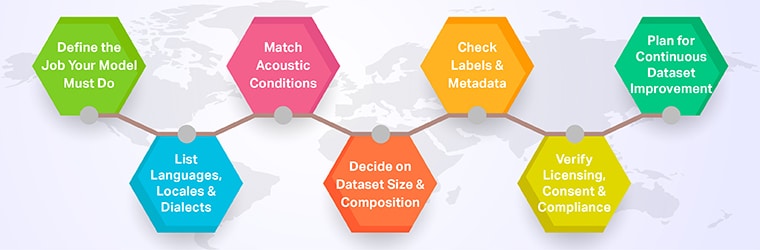
पायरी १ - तुमच्या मॉडेलने कोणते काम करावे हे परिभाषित करा
- कार्यः डिक्टेशन, व्हॉइस सर्च, कॉन्टॅक्ट सेंटर अॅनालिटिक्स, रिअल-टाइम कॅप्शन, अनुपालन देखरेख इ.
- चॅनेल: टेलिफोनी (८ किलोहर्ट्झ), मोबाईल अॅप, दूरवरचे स्मार्ट स्पीकर्स, कारमधील मायक्रोफोन.
- गुणवत्ता बार: लक्ष्य WER, विलंब, प्रतिसाद वेळ, नियामक आवश्यकता.
पायरी २ - भाषा, स्थानिक भाषा आणि बोलीभाषा सूचीबद्ध करा
- कोणत्या भाषा आणि रूपे (उदा., अमेरिकन इंग्रजी विरुद्ध भारतीय इंग्रजी विरुद्ध सिंगापूर इंग्रजी)?
- आपल्याला गरज आहे कोड-मिक्स्ड भाषण (हिंदी-इंग्रजी, स्पॅनिश-इंग्रजी, इ.)?
- तुम्ही कमी-संसाधन असलेल्या भाषांना लक्ष्य करत आहात जिथे ओपन डेटा विरळ आहे?
पायरी ३ - ध्वनिक परिस्थिती जुळवा
- टेलिफोनी विरुद्ध वाइडबँड विरुद्ध मल्टी-माइक अॅरे.
- शांत ऑफिस विरुद्ध गोंगाट करणारा रस्ता विरुद्ध चालती गाडी.
- जवळचे क्षेत्र विरुद्ध दूरचे क्षेत्र मायक्रोफोन.
तुमचा डेटासेट तुमच्या वापरकर्त्यांच्या वास्तविक वातावरणाचे प्रतिबिंब असायला हवा.
पायरी ४ - डेटासेटचा आकार आणि रचना ठरवा
अंगठ्याचे नियम (कठोर नाही):
- पूर्व-प्रशिक्षित मॉडेलचे सुधारण (कुजबुजणे, wav2vec2, इ.)
- डझनभर ते काहीशे तासांचा उच्च-गुणवत्तेचा, डोमेन-मॅच केलेला डेटा सुईला खूप हलवू शकतो.
- मॉडेलला सुरवातीपासून प्रशिक्षण देणे
- सहसा हजारो ते दहा हजार तास लागतात, म्हणूनच अनेक संघ पूर्व-प्रशिक्षित प्रणालींपासून सुरुवात करतात आणि डेटा फाइन-ट्यूनिंगवर बजेट केंद्रित करतात.
मिक्स:
- काही स्वच्छ स्क्रिप्टेड डेटा (मुख्य ध्वन्यात्मकता, संख्यांसाठी).
- वास्तववादी संभाषणात्मक डेटा (मजबूतीसाठी).
- डोमेन-विशिष्ट एज केसेस (दुर्मिळ घटक, लांब संख्या, शब्दजाल).
पायरी ५ - लेबल्स आणि मेटाडेटा तपासा
क्लासिक ASR साठी, तुम्हाला किमान हे आवश्यक आहे:
- अचूक उतारे
- मूलभूत स्पीकर टॅग्ज
- सुसंगत विरामचिन्हे आणि केसिंग नियम
LLM + ASR पाइपलाइनसाठी, तुम्हाला हे देखील हवे आहे:
- स्पीकर वळण विभागणी (कोण काय म्हणाले, कधी)
- कॉल/संभाषण परिणाम (निराकरण केलेले, वाढवलेले, तक्रारीचा प्रकार)
- अस्तित्वाची भाष्ये (नावे, खाते क्रमांक, उत्पादनांची नावे)
- जिथे संबंधित असेल तिथे भावना किंवा भावनांचे टॅग.
हे लेबल्स तुम्हाला ट्रान्सक्रिप्ट्सवर आधारित सारांश, गुणवत्ता आश्वासन (QA), प्रशिक्षण (कोचिंग), मार्गक्रमण (राउटिंग) आणि RAG पाइपलाइन्स तयार करू देतात —जिथे आता बरेच व्यावसायिक मूल्य दडलेले असते.
पायरी ६ - परवाना, संमती आणि अनुपालन पडताळून पहा
प्रशिक्षण घेण्यापूर्वी:
- डेटासेटसाठी परवानाकृत आहे का? व्यावसायिक वापर (फक्त संशोधन नाही)?
- या वापरासाठी वक्त्यांना माहिती आणि संमती देण्यात आली होती का?
- PII आणि संवेदनशील गुणधर्म GDPR / HIPAA / स्थानिक नियमांनुसार हाताळले जातात का?
अनेक खुले डेटासेट CC-BY किंवा CC0 सारखे परवाने वापरतात , ज्या प्रत्येकासोबत वेगवेगळ्या जबाबदाऱ्या येतात. शंका असल्यास, कायदेशीर पुनरावलोकन ही एक अनिवार्य पायरी माना.
पायरी ७ – सतत डेटासेट सुधारणांसाठी योजना
भाषा विकसित होतात, तुमचे उत्पादन विकसित होते आणि तुमचा डेटासेट देखील विकसित झाला पाहिजे:
- वास्तविक जगातील चुका पहा आणि चुकीच्या ओळखी तुमच्या प्रशिक्षण संचात परत आणा.
- तुमचा डोमेन बदलत असताना नवीन संस्था (ब्रँड, SKU, नियामक संज्ञा) जोडा.
- पक्षपात कमी करण्यासाठी वेळोवेळी उच्चार आणि लोकसंख्याशास्त्राचे पुनर्संतुलन करा.
ही बंदिस्त प्रणाली अनेकदा ‘पुरेशी चांगली’ आणि ‘बाजारात अग्रगण्य’ अशा भाषण उत्पादनांमधील सर्वात मोठा भेद ठरवते.
[हे सुद्धा वाचा: आमच्या दर्जेदार भारतीय भाषेतील ऑडिओ डेटासेटचा वापर करून एआय मॉडेल्सची क्षमता वाढवा .]
Shaip कशी मदत करू शकते
जर तुम्ही ‘मला अधिक चांगल्या स्पीच डेटाची गरज आहे हे माहित आहे, पण सुरुवात कुठून करावी हे मला कळत नाही’ या टप्प्यावर असाल , तर शेप तुम्हाला मदत करू शकतात:
- तुमच्या विद्यमान डेटासेटचे ऑडिट करा आणि ओळखा कव्हरेज गॅप
- प्रदान ऑफ-द-शेल्फ स्पीच रेकग्निशन डेटासेट ६५+ भाषांमध्ये आणि डझनभर डोमेनमध्ये (स्क्रिप्टेड, कॉल सेंटर, वेक वर्ड्स, टीटीएस, इ.)
- डिझाइन आणि अंमलबजावणी सानुकूल डेटा संग्रह प्रोग्राम्स (रिमोट, इन-कंट्री, मल्टी-डिव्हाइस)
- हाताळणी भाष्य, लिप्यंतरण, गुणवत्ता नियंत्रण आणि ओळख रद्द करणे या टोकापासून त्या टोकापर्यंत
त्यामुळे तुमची टीम मॉडेल्स आणि उत्पादनांवर लक्ष केंद्रित करू शकते , तर आम्ही याची खात्री करतो की तुमच्या AI ला ऐकण्यासाठी आणि समजून घेण्यासाठी आवश्यक असलेला उच्च-गुणवत्तेचा, अनुरूप स्पीच डेटा मिळेल.