एआय डेटा संकलन: आपल्याला माहित असणे आवश्यक असलेली प्रत्येक गोष्ट
इंटेलिजेंट एआय आणि एमएल मॉडेल उद्योगांमध्ये बदल करत आहेत, भविष्यसूचक आरोग्यसेवेपासून ते स्वायत्त वाहने आणि बुद्धिमान चॅटबॉट्सपर्यंत. पण या शक्तिशाली मॉडेल्सना काय इंधन मिळते? डेटा. उच्च-गुणवत्तेचा डेटा आणि बरेच काही. हे मार्गदर्शक AI साठी डेटा संकलनाचे सर्वसमावेशक विहंगावलोकन प्रदान करते, ज्यामध्ये नवशिक्याला माहित असणे आवश्यक असलेल्या सर्व गोष्टींचा समावेश होतो.
AI साठी डेटा कलेक्शन म्हणजे काय?
AI साठी डेटा संकलनामध्ये मशीन लर्निंग मॉडेलला प्रशिक्षण देण्यासाठी आवश्यक असलेला कच्चा डेटा गोळा करणे आणि तयार करणे समाविष्ट आहे. हा डेटा मजकूर, प्रतिमा, ऑडिओ आणि व्हिडिओसह विविध रूपे घेऊ शकतो. प्रभावी AI प्रशिक्षणासाठी, गोळा केलेला डेटा असा असावा:
- प्रचंड: मजबूत AI मॉडेल्सना प्रशिक्षण देण्यासाठी मोठ्या डेटासेटची आवश्यकता असते.
- विविध: डेटाने मॉडेलला येणाऱ्या वास्तविक-जगातील परिवर्तनशीलतेचे प्रतिनिधित्व केले पाहिजे.
- लेबल केलेले: पर्यवेक्षी शिक्षणासाठी, मॉडेलच्या शिक्षणाचे मार्गदर्शन करण्यासाठी डेटा योग्य उत्तरांसह टॅग करणे आवश्यक आहे.
उपाय: डेटा संकलन (एमएल मॉडेल्सना प्रशिक्षित करण्यासाठी मोठ्या प्रमाणात डेटा संकलन.)

एमएल मॉडेल्ससाठी एआय प्रशिक्षण डेटा प्राप्त करणे
प्रभावी डेटा संकलनामध्ये काळजीपूर्वक नियोजन आणि अंमलबजावणी समाविष्ट असते. मुख्य विचारांमध्ये हे समाविष्ट आहे:
- उद्दिष्टे परिभाषित करणे: डेटा संकलन सुरू करण्यापूर्वी तुमच्या AI प्रकल्पाची उद्दिष्टे स्पष्टपणे ओळखा.
- डेटासेट तयार करणे: एकाधिक डेटासेटसाठी योजना (प्रशिक्षण, प्रमाणीकरण, चाचणी).
बजेट व्यवस्थापन: डेटा संकलन आणि भाष्यासाठी वास्तववादी बजेट तयार करा. - डेटा प्रासंगिकताः संकलित केलेला डेटा विशिष्ट AI मॉडेल आणि त्याचा हेतू असलेल्या वापराशी संबंधित असल्याची खात्री करा.
- अल्गोरिदम सुसंगतता: तुम्ही वापरत असलेले अल्गोरिदम आणि त्यांच्या डेटा आवश्यकतांचा विचार करा.
- शिकण्याचा दृष्टिकोन: तुम्ही पर्यवेक्षी, पर्यवेक्षण न केलेले किंवा मजबुतीकरण शिक्षण वापरणार आहात हे ठरवा.
डेटा संकलन पद्धती
प्रशिक्षण डेटा प्राप्त करण्यासाठी अनेक पद्धती वापरल्या जाऊ शकतात:
- मुक्त स्रोत: सार्वजनिकरित्या उपलब्ध डेटासेट (उदा., Kaggle, Google डेटासेट, OpenML), खुले मंच (उदा., Reddit, Quora). टीप: विनामूल्य डेटासेटची गुणवत्ता आणि प्रासंगिकतेचे काळजीपूर्वक मूल्यांकन करा.
- अंतर्गत स्रोत: तुमच्या संस्थेतील डेटा (उदा. CRM, ERP सिस्टम).
- सशुल्क स्रोत: तृतीय-पक्ष डेटा प्रदाता, डेटा स्क्रॅपिंग साधने.

डेटा संकलनासाठी बजेटिंग
डेटा संकलनासाठी बजेटमध्ये अनेक घटकांचा विचार करणे आवश्यक आहे:
- प्रकल्पाची व्याप्ती: आकार, गुंतागुंत, AI तंत्रज्ञानाचा प्रकार (उदा. सखोल शिक्षण, NLP, संगणक दृष्टी).
- डेटा व्हॉल्यूम: आवश्यक डेटाची रक्कम प्रकल्पाच्या जटिलतेवर आणि मॉडेलच्या आवश्यकतांवर अवलंबून असते.
- किंमत धोरण: डेटा गुणवत्ता, अवघडपणा आणि प्रदात्याच्या कौशल्यावर आधारित विक्रेत्याची किंमत बदलते.
- सोर्सिंग पद्धत: डेटा आंतरिकरित्या, विनामूल्य स्त्रोतांकडून किंवा सशुल्क विक्रेत्यांकडून घेतला जातो यावर अवलंबून खर्च भिन्न असतील.

डेटा क्वालिटी कशी मोजायची?
सिस्टममध्ये दिलेला डेटा उच्च दर्जाचा आहे की नाही याची खात्री करण्यासाठी, तो खालील पॅरामीटर्सचे पालन करतो याची खात्री करा:
- विशिष्ट वापर प्रकरणासाठी हेतू
- मॉडेल अधिक बुद्धिमान बनविण्यात मदत करते
- निर्णय घेण्यास गती मिळेल
- रिअल-टाइम रचना दर्शवते
नमूद केलेल्या पैलूंनुसार, तुमच्या डेटासेटमध्ये अशी वैशिष्ट्ये आहेत जी तुम्हाला हवी आहेत:
- एकसारखेपणा: जरी डेटाचे भाग एकाधिक मार्गांवरून प्राप्त केले गेले असले तरीही, मॉडेलवर अवलंबून, त्यांची समान तपासणी करणे आवश्यक आहे. उदाहरणार्थ, केवळ चॅटबॉट्स आणि व्हॉईस असिस्टंट्स सारख्या NLP मॉडेल्ससाठी असलेल्या ऑडिओ डेटासेटसह पेअर केल्यास उत्तम-अनुकूल भाष्य केलेला व्हिडिओ डेटासेट एकसमान होणार नाही.
- सातत्य: डेटासेटला उच्च दर्जाचे म्हणायचे असल्यास ते सुसंगत असले पाहिजेत. याचा अर्थ डेटाच्या प्रत्येक युनिटने इतर कोणत्याही युनिटला पूरक घटक म्हणून मॉडेलसाठी जलद निर्णय घेण्याचे लक्ष्य ठेवले पाहिजे.
- व्यापकता: मॉडेलच्या प्रत्येक पैलूची आणि वैशिष्ट्यांची योजना करा आणि स्त्रोत डेटासेट सर्व बेस कव्हर करत असल्याची खात्री करा. उदाहरणार्थ, NLP-संबंधित डेटाने सिमेंटिक, सिंटॅक्टिक आणि अगदी संदर्भात्मक आवश्यकतांचे पालन केले पाहिजे.
- प्रासंगिकताः तुमच्या मनात काही परिणाम असल्यास, डेटा एकसमान आणि संबंधित असल्याची खात्री करा, AI अल्गोरिदम सहजतेने त्यावर प्रक्रिया करू शकतील.
- वैविध्यपूर्ण: 'एकरूपता' भागाला विरोधाभास वाटतो? जर तुम्हाला मॉडेलला सर्वांगीण प्रशिक्षण द्यायचे असेल तर वैविध्यपूर्ण डेटासेट महत्त्वाचे नाहीत. हे बजेट वाढवू शकते, परंतु मॉडेल अधिक हुशार आणि आकलनक्षम बनते.
- अचूकता: डेटा त्रुटी आणि विसंगतींपासून मुक्त असावा.
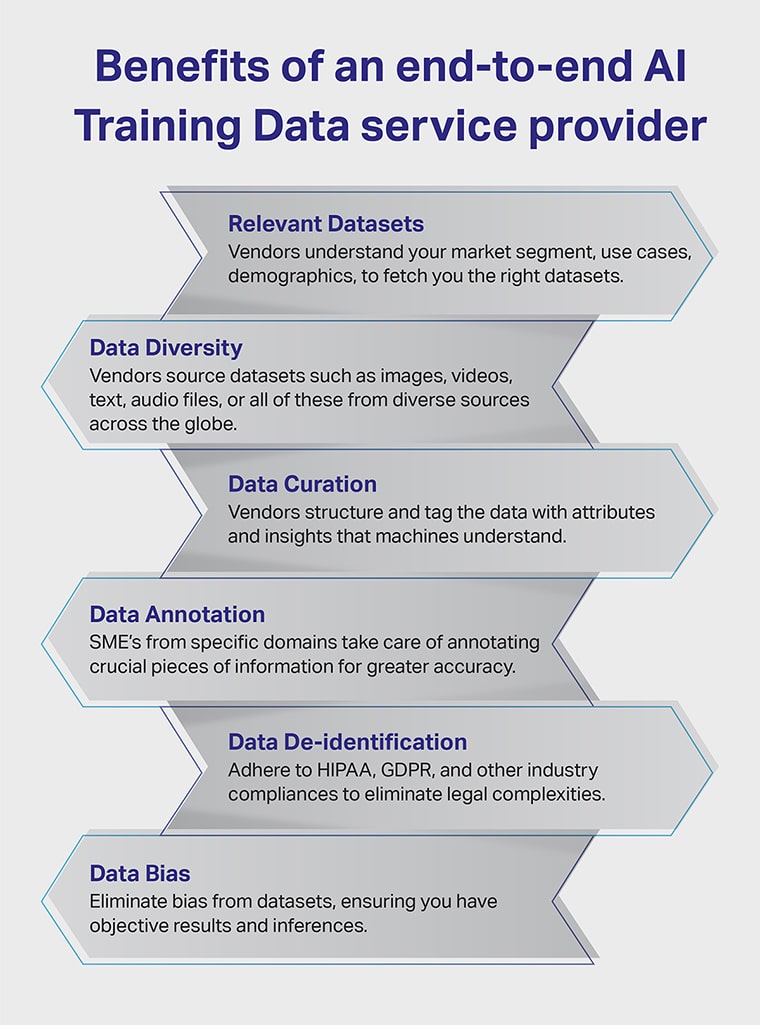
एंड-टू-एंड AI प्रशिक्षण डेटा सेवा प्रदाता ऑनबोर्डिंगचे फायदे
फायदे सूचीबद्ध करण्यापूर्वी, एकूण डेटा गुणवत्ता निर्धारित करणारे पैलू येथे आहेत:
- प्लॅटफॉर्म वापरले
- सहभागी लोक
- प्रक्रिया अनुसरली
आणि अनुभवी एंड-टू-एंड सेवा प्रदात्यासह, तुम्हाला सर्वोत्तम प्लॅटफॉर्म, सर्वात अनुभवी लोक आणि चाचणी केलेल्या प्रक्रियांमध्ये प्रवेश मिळतो ज्या तुम्हाला मॉडेलला परिपूर्णतेसाठी प्रशिक्षित करण्यात मदत करतात.
तपशीलांसाठी, येथे काही अधिक क्युरेट केलेले फायदे आहेत जे अतिरिक्त स्वरूपासाठी पात्र आहेत:
- प्रासंगिकताः एंड-टू-एंड सेवा प्रदाते फक्त मॉडेल आणि अल्गोरिदम-विशिष्ट डेटासेट प्रदान करण्यासाठी पुरेसे अनुभवी आहेत. शिवाय, ते सिस्टमची जटिलता, लोकसंख्याशास्त्र आणि बाजार विभागणी देखील विचारात घेतात.
- विविधता: काही मॉडेल्सना अचूकपणे निर्णय घेण्यास सक्षम होण्यासाठी संबंधित डेटासेटच्या ट्रकलोडची आवश्यकता असते. उदाहरणार्थ, स्व-ड्रायव्हिंग कार. एंड-टू-एंड, अनुभवी सेवा प्रदाते अगदी विक्रेता-केंद्रित डेटासेट सोर्स करून विविधतेची गरज लक्षात घेतात. सोप्या भाषेत सांगायचे तर, मॉडेल्स आणि अल्गोरिदमला जे काही समजेल ते सर्व उपलब्ध करून दिले आहे.
- क्युरेटेड डेटा: अनुभवी सेवा प्रदात्यांबद्दलची सर्वात चांगली गोष्ट म्हणजे ते डेटासेट निर्मितीसाठी चरणबद्ध दृष्टिकोनाचे पालन करतात. ते भाष्यकारांना अर्थ देण्यासाठी गुणधर्मांसह संबंधित भाग टॅग करतात.
- हाय-एंड भाष्य: अनुभवी सेवा प्रदाते परिपूर्णतेसाठी डेटाच्या मोठ्या भागांवर भाष्य करण्यासाठी संबंधित विषय तज्ञांना तैनात करतात.
- मार्गदर्शक तत्त्वांनुसार ओळख रद्द करा: डेटा सुरक्षा नियम तुमची AI प्रशिक्षण मोहीम बनवू किंवा खंडित करू शकतात. तथापि, एंड-टू-एंड सेवा प्रदाते, जीडीपीआर, एचआयपीएए आणि इतर प्राधिकरणांशी संबंधित प्रत्येक अनुपालन समस्येची काळजी घेतात आणि तुम्हाला प्रकल्प विकासावर पूर्णपणे लक्ष केंद्रित करू देतात.
- शून्य पूर्वाग्रह: इन-हाउस डेटा कलेक्टर्स, क्लीनर आणि एनोटेटर्सच्या विपरीत, विश्वासार्ह सेवा प्रदाते अधिक वस्तुनिष्ठ परिणाम आणि अचूक निष्कर्ष मिळवण्यासाठी मॉडेल्समधून AI पूर्वाग्रह दूर करण्यावर भर देतात.

योग्य डेटा संकलन विक्रेता निवडत आहे
प्रत्येक AI प्रशिक्षण मोहीम डेटा संकलनाने सुरू होते. किंवा, असे म्हणता येईल की तुमचा AI प्रकल्प अनेकदा टेबलवर आणलेल्या डेटाच्या गुणवत्तेइतकाच प्रभावशाली असतो.
म्हणून, नोकरीसाठी योग्य डेटा संग्रह विक्रेता ऑनबोर्ड करणे उचित आहे, जो खालील मार्गदर्शक तत्त्वांचे पालन करतो:
- नवीनता किंवा वेगळेपणा
- वेळेवर वितरण
- अचूकता
- पूर्णता
- सातत्य
आणि योग्य निवडीमध्ये शून्य करण्यासाठी तुम्हाला संस्था म्हणून तपासण्याची आवश्यकता असलेले घटक येथे आहेत:
- डेटा गुणवत्ता: गुणवत्तेचे मूल्यांकन करण्यासाठी नमुना डेटासेटची विनंती करा.
- अनुपालनः संबंधित डेटा गोपनीयता नियमांचे पालन सत्यापित करा.
- प्रक्रियेची पारदर्शकता: त्यांच्या डेटा संकलन आणि भाष्य प्रक्रिया समजून घ्या.
- पक्षपात कमी करणे: Iपूर्वाग्रह संबोधित करण्याच्या त्यांच्या दृष्टिकोनाबद्दल विचारा.
- स्केलेबिलिटी तुमच्या प्रकल्पाच्या वाढीसह त्यांची क्षमता वाढू शकते याची खात्री करा.
प्रारंभ करण्यास तयार आहात?
डेटा संकलन हा कोणत्याही यशस्वी AI प्रकल्पाचा पाया असतो. या मार्गदर्शकामध्ये वर्णन केलेल्या मुख्य विचार आणि सर्वोत्तम पद्धती समजून घेऊन, तुम्ही शक्तिशाली आणि प्रभावी AI मॉडेल तयार करण्यासाठी आवश्यक डेटा प्रभावीपणे मिळवू शकता आणि तयार करू शकता. आमच्या डेटा संकलन सेवांबद्दल अधिक जाणून घेण्यासाठी आजच आमच्याशी संपर्क साधा.
मुख्य डेटा संकलन संकल्पनांच्या दृश्य सारांशासाठी आमचे इन्फोग्राफिक डाउनलोड करा.