
प्रगत AI विकासासाठी उच्च-गुणवत्तेचे संगणक व्हिजन डेटासेट
हेल्थकेअर, ई-कॉमर्स, रोबोटिक्स, स्वायत्त ड्रायव्हिंग आणि बरेच काही मध्ये विशिष्ट वापर प्रकरणांसाठी तयार केलेली प्रतिमा आणि व्हिडिओ डेटासेट

भाषा आणि मजकूर डेटासेट
या डेटासेटमध्ये अरबी, चीनी, इंग्रजी, जपानी आणि अधिक सारख्या भाषांमधील बहुभाषी मजकूर आणि हस्तलेखन नमुने आहेत. ते प्रामुख्याने ओसीआर (ऑप्टिकल कॅरेक्टर रिकग्निशन), मजकूर वर्गीकरण आणि भाषांतर मॉडेल सारख्या समर्थन कार्यांसाठी, नैसर्गिक भाषा प्रक्रिया, मजकूर ओळख आणि बहुभाषिक अनुप्रयोगांसाठी डिझाइन केलेले आहेत.

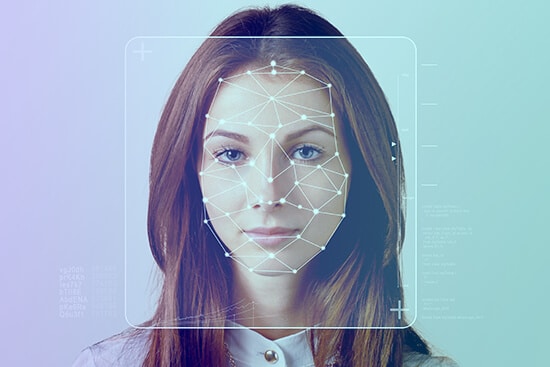
चेहरा ओळख डेटासेट
या डेटासेटमध्ये चेहऱ्याची वैशिष्ट्ये आणि विशिष्ट शरीराचे भाग समाविष्ट आहेत, ज्यामध्ये चेहऱ्याची ओळख, अभिव्यक्ती शोधणे आणि भागांचे विभाजन यासारख्या अनुप्रयोगांचा समावेश आहे. ते बायोमेट्रिक्स, सुरक्षा आणि चेहऱ्यावरील अभिव्यक्ती विश्लेषण यासारख्या अनुप्रयोगांमध्ये उपयुक्त असलेले चेहरा आणि शरीर ओळख, ट्रॅकिंग आणि ओळख मॉडेल विकसित करण्यात मदत करतात.
कपडे आणि फॅशन डेटासेट
कपडे आणि फॅशन डेटासेट परिधान वस्तूंसाठी विभागणी, वर्गीकरण आणि मुख्य पॉइंट डेटा प्रदान करतात. हे डेटासेट कपड्यांचे प्रकार, नमुने आणि ॲक्सेसरीज यांसारख्या विविध पैलूंचे विश्लेषण करून फॅशन शिफारस इंजिन, व्हर्च्युअल ट्राय-ऑन आणि रिटेल इन्व्हेंटरी व्यवस्थापनास समर्थन देतात.

जेश्चर, पोझ आणि क्रियाकलाप डेटासेट
या डेटासेटमध्ये मानवी क्रियाकलाप ओळखण्यासाठी जेश्चर आणि पोझ-संबंधित डेटा समाविष्ट आहे. ते स्केलेटन-आधारित मुख्य बिंदू, हाताचे जेश्चर आणि मानवी मुद्रा, AR/VR, जेश्चर ओळख, गेमिंग आणि मानवी-संगणक परस्परसंवाद यांसारख्या सपोर्टिंग ऍप्लिकेशन्सवर लक्ष केंद्रित करतात.

विशिष्ट ऑब्जेक्ट आणि कॉन्टूर सेगमेंटेशन डेटासेट
हे डेटासेट अन्न, इमारती आणि यंत्रसामग्री यासारख्या विशिष्ट वस्तू आणि रूपरेषा यांचे तपशीलवार विभाजन प्रदान करतात. ते प्रशिक्षण मॉडेल्सना विशिष्ट आकार, वस्तू आणि सीमा ओळखण्यासाठी आणि विभागण्यासाठी उपयुक्त आहेत, रोबोटिक्समधील वापर प्रकरणांना समर्थन देतात, गुणवत्ता नियंत्रण आणि स्वयंचलित तपासणी.

ऑटोमोटिव्ह डेटासेट
या श्रेणीतील डेटासेट औद्योगिक अनुप्रयोगांवर लक्ष केंद्रित करतात, ज्यात मशीनचे भाग, खराब झालेले उपकरणे आणि बारकोडच्या प्रतिमा समाविष्ट आहेत. हे डेटासेट गुणवत्तेची हमी, स्वयंचलित मशीन तपासणी, दोष शोधणे आणि औद्योगिक प्रक्रिया निरीक्षणामध्ये मदत करतात, जे उत्पादन आणि वेअरहाऊस ऑटोमेशनसाठी आदर्श आहेत.

अँटी-स्पूफिंग डेटासेट्स
वापरण्यास तयार, परवानाकृत अँटी-स्पूफिंग व्हिडिओ डेटासेट, जे चेहऱ्यावरील जिवंतपणा शोधण्यासाठी वापरले जातात, ज्यामध्ये 3D मास्क, मेकअप, रिप्ले आणि रिअल-वि-स्पूफ परिस्थिती समाविष्ट आहेत. अनिनोटेड क्लिप्स प्रीट्रेनिंग आणि मूल्यांकनासाठी योग्य आहेत, ज्यामध्ये पर्यायी कस्टम कलेक्शन, तज्ञ लेबलिंग आणि लवचिक परवाना अंतर्गत गोपनीयता सुरक्षा उपायांचा समावेश आहे.

व्हिडिओ डेटासेट
एआयसाठी ऑफ-द-शेल्फ, परवानाकृत व्हिडिओ डेटासेट: YouTube Kids (८० हजार तास), लघुपट आणि लग्न (५०० तास), ऐतिहासिक माहितीपट (५०० तास), माहितीपट चित्रपट निर्मात्यांचा संग्रह (आठ देशांमध्ये ३,००० तास), आणि मार्शल-आर्ट्स लढाया (१,००० तास). सर्व भाष्य न केलेले; पर्यायी संग्रह, भाष्य आणि ओळख रद्द करणे.

नेहमी विचारले जाणारे प्रश्न (एफएक्यू)
१. संगणक व्हिजन डेटासेट म्हणजे काय?
संगणक व्हिजन डेटासेट हे लेबल केलेल्या प्रतिमा आणि व्हिडिओंचे संग्रह आहेत जे AI/ML मॉडेल्सना वास्तविक जगातील दृश्य डेटा ओळखण्यासाठी, विश्लेषण करण्यासाठी आणि अर्थ लावण्यासाठी प्रशिक्षित करण्यासाठी वापरले जातात.
२. संगणक दृष्टी डेटासेट का महत्त्वाचे आहेत?
ऑब्जेक्ट डिटेक्शन, इमेज क्लासिफिकेशन, सेगमेंटेशन आणि अॅक्टिव्हिटी रिकग्निशन सारखी कामे करण्यासाठी एआय सिस्टीमना प्रशिक्षण देण्यासाठी हे डेटासेट आवश्यक आहेत. ते एआय/एमएल मॉडेल्सना व्हिज्युअल माहिती अचूकपणे समजून घेण्यास आणि प्रक्रिया करण्यास सक्षम करतात.
३. कोणते उद्योग संगणक व्हिजन डेटासेट वापरतात?
आरोग्यसेवा, ई-कॉमर्स, रिटेल, ऑटोनॉमस ड्रायव्हिंग आणि सुरक्षा यासारखे उद्योग रुग्ण निदान, उत्पादन शिफारस इंजिन, नेव्हिगेशन आणि गुणवत्ता नियंत्रण यासारख्या अनुप्रयोगांसाठी या डेटासेटचा वापर करतात.
४. संगणक दृष्टी डेटासेट कसे गोळा केले जातात?
वेगवेगळ्या लोकसंख्याशास्त्र, प्रकाश परिस्थिती आणि परिस्थितींमध्ये प्रतिनिधित्व सुनिश्चित करण्यासाठी विविध आणि नियंत्रित वातावरणातून डेटासेट गोळा केले जातात. रिझोल्यूशन, फाइल स्वरूप आणि गुणवत्तेसाठी कठोर मार्गदर्शक तत्त्वांचे पालन केले जाते.
५. हे डेटासेट कसे भाष्य केले जातात?
एआय प्रशिक्षणासाठी तपशीलवार आणि अचूक माहिती प्रदान करण्यासाठी भाष्यामध्ये प्रतिमा आणि व्हिडिओंना मेटाडेटा, बाउंडिंग बॉक्स, लँडमार्क, मुख्य मुद्दे आणि सेगमेंटेशन मास्कसह लेबल करणे समाविष्ट आहे.
६. डेटासेट गोपनीयतेचे पालन करतात का?
होय, सर्व डेटासेट GDPR सारख्या जागतिक गोपनीयता मानकांचे पालन करतात, नैतिक सोर्सिंग, वैयक्तिक डेटाची ओळख काढून टाकणे आणि योगदानकर्त्याची संमती सुनिश्चित करतात.
६. डेटासेट कस्टमाइझ करता येतात का?
होय, डेटासेट विशिष्ट प्रकल्प आवश्यकतांनुसार तयार केले जाऊ शकतात, जसे की लोकसंख्याशास्त्र, पर्यावरणीय परिस्थिती, वस्तूंचे प्रकार किंवा उद्योग-विशिष्ट वापर प्रकरणे.
८. डेटासेटची गुणवत्ता कशी सुनिश्चित केली जाते?
कठोर प्रमाणीकरण प्रक्रिया, तज्ञांची टिप्पणी आणि प्रतिमा स्पष्टता, रिझोल्यूशन आणि सुसंगततेसाठी कठोर मार्गदर्शक तत्त्वांचे पालन करून गुणवत्ता सुनिश्चित केली जाते.
१२. हे डेटासेट एआय वर्कफ्लोमध्ये कसे एकत्रित होऊ शकतात?
डेटासेट JSON, CSV किंवा XML सारख्या मानक स्वरूपात तपशीलवार मेटाडेटासह वितरित केले जातात, ज्यामुळे प्रशिक्षण, चाचणी आणि प्रमाणीकरणासाठी AI/ML वर्कफ्लोमध्ये ते एकत्रित करणे सोपे होते.
१३. कोणते परवाना पर्याय उपलब्ध आहेत?
विशिष्ट प्रकल्प गरजा पूर्ण करण्यासाठी ऑफ-द-शेल्फ डेटासेट किंवा पूर्णपणे सानुकूलित उपायांसह लवचिक परवाना पर्याय प्रदान केले जातात.
११. संगणक व्हिजन डेटासेटची किंमत किती आहे?
डेटासेट आकार, कस्टमायझेशनची पातळी आणि परवाना आवश्यकतांवर अवलंबून किंमत बदलते. तपशीलवार कोटसाठी आमच्याशी संपर्क साधा.
12. वितरण टाइमलाइन काय आहेत?
वितरणाची वेळ प्रकल्पाच्या आकारमानावर आणि गुंतागुंतीवर अवलंबून असते, परंतु ती कार्यक्षमतेने मुदती पूर्ण करण्यासाठी डिझाइन केलेली असते.
